
资料来源:虚拟化部分 16 份课件,包括进程抽象、进程 API、受限直接执行、进程调度、MLFQ/比例份额、多处理器调度、地址空间、内存 API、地址转换、分段、分页、TLB、小页表、交换机制与交换策略。
复习主线
虚拟化要抓住一条线:操作系统把少量真实硬件包装成多个程序“各自独占”的假象,同时保持效率、控制和保护。
- CPU 虚拟化:用进程、上下文切换、受限直接执行、时钟中断和调度算法,让多个程序共享 CPU。
- 内存虚拟化:用地址空间、地址转换、分段、分页和 TLB,让每个进程看到独立、连续、受保护的虚拟内存。
- 超越物理内存:用交换空间、缺页异常和页面置换,让虚拟地址空间可以大于物理内存。
核心矛盾:
- 透明性:进程最好感觉不到自己在共享资源。
- 效率:虚拟化不能让程序慢太多。
- 控制:操作系统必须能随时收回 CPU、限制内存访问、处理异常。
- 保护:进程不能随便访问其他进程或内核。
一、CPU 虚拟化与进程
1. 为什么需要进程
早期单道程序系统中,内存里通常只装一个用户程序,CPU 只执行这一道程序。如果程序等待 I/O,CPU 就可能空闲,利用率低。
多道程序设计把多个程序同时放入内存,通过切换执行提高 CPU 利用率和系统吞吐量。但多个程序并发带来新问题:程序运行到哪里、寄存器是什么值、打开了哪些文件、占用了哪些资源、是否互相干扰,都需要被记录和管理。因此操作系统引入进程。
进程可以理解为:
$$ \text{进程}=\text{正在执行的程序}+\text{当前运行状态}+\text{操作系统管理的资源信息} $$
程序本身只是磁盘上的代码和静态数据;进程是程序运行起来之后的动态实体。
2. CPU 虚拟化
CPU 虚拟化是操作系统制造“很多虚拟 CPU”的假象。真实 CPU 数量有限,例如 8 个核心,但系统可以运行远多于 8 个进程。
实现方式是时分共享(Time Sharing):让一个进程运行一小段时间,再切换到另一个进程。用户看到的是多个程序似乎同时运行。
代价是性能损失:
- 每个进程实际只能间歇性获得 CPU。
- 上下文切换有开销。
- 缓存和 TLB 可能被破坏,恢复局部性也要时间。
3. 进程控制块 PCB
PCB 是 Process Control Block,全称进程控制块。它是操作系统描述和管理进程的核心数据结构。
PCB 通常保存:
- 进程标识信息:PID(Process Identifier,进程 ID)、PPID(Parent Process Identifier,父进程 ID)、UID(User Identifier,用户 ID)。
- CPU 现场:PC(Program Counter,程序计数器)、通用寄存器、标志寄存器。
- 栈相关寄存器:SP(Stack Pointer,栈指针)、FP(Frame Pointer,栈帧指针)。
- 调度信息:进程状态、优先级、运行时间、队列位置。
- 内存信息:地址空间、页表或段表相关指针。
- I/O 信息:打开文件列表、文件描述符、当前目录等。
为什么进程被暂停后还能从原位置恢复?因为暂停时操作系统把 CPU 现场保存到 PCB;恢复时再把 PCB 中的现场装回 CPU。
4. 进程地址空间的基本组成
一个运行中的进程通常看到如下虚拟地址空间:
- 代码段(Code Segment):程序指令,通常只读。
- 已初始化数据段:已经赋初值的全局变量和静态变量。
- 未初始化数据段:BSS(Block Started by Symbol),存放未初始化或初始化为 0 的全局/静态变量。
- 堆(Heap):动态内存分配区域,通常向高地址增长。
- 栈(Stack):函数调用、局部变量、参数、返回地址,通常向低地址增长。
- 命令行参数与环境变量。
- 内核映射区域:内核可能映射到每个进程地址空间中,但用户态进程不能直接访问。
5. 从程序到进程
程序变成进程时,操作系统通常要做这些事:
- 读取可执行文件,把代码和静态数据装入进程地址空间。Linux 常见格式是 ELF(Executable and Linkable Format,可执行与可链接格式),Windows 常见格式是 PE(Portable Executable,可移植可执行文件格式)。
- 为运行时栈分配内存,并把
main(argc, argv)需要的命令行参数和环境变量放好。 - 为堆建立初始区域。堆通常按需增长,
malloc()请求时才真正分配更多空间。 - 初始化 I/O 环境。UNIX/Linux 进程默认打开
STDIN=0、STDOUT=1、STDERR=2。 - 初始化 PCB、寄存器、页表/段表等内核数据结构。
- 把 CPU 控制权交给进程,从程序入口或
main()附近开始执行。
“按需”是重要思想:代码、数据、堆页面不一定一次性全部装入物理内存,后续可通过分页和缺页异常逐步调入。
6. 进程状态
基本三状态:
- 运行(Running):正在 CPU 上执行指令。
- 就绪(Ready):已经准备好运行,但 CPU 当前没有分配给它。
- 阻塞(Blocked):等待某个事件,例如 I/O 完成。
常见扩展状态:
- 初始状态(Initial):进程正在创建。
- 终止/最终状态(Final):进程已退出,等待资源回收。
- 僵尸状态(Zombie):子进程已经结束,但父进程还没有通过
wait()回收其退出状态,进程表项仍存在。
状态转换:
- Ready -> Running:被调度(Scheduled)。
- Running -> Ready:被取消调度或被抢占(Descheduled/Preempted)。
- Running -> Blocked:发起 I/O 或等待事件。
- Blocked -> Ready:等待事件完成,例如 I/O 中断到达。
二、进程 API 与系统调用
API 是 Application Programming Interface,全称应用程序编程接口。进程 API 是操作系统提供给程序管理进程的接口。
1. 常见进程 API
- 创建:
fork()、exec()、clone()。 - 销毁:
kill(pid, SIGTERM)等。 - 等待:
wait()、waitpid()。 - 控制:
SIGSTOP暂停,SIGCONT继续。 - 状态查询:
/proc/<pid>/status、ps、pstree、top、htop。
SIG 是 Signal,全称信号。信号是操作系统向进程传递事件的一种机制。
2. fork()
fork() 用于创建子进程。调用后,父进程和子进程都会从 fork() 返回处继续执行。
关键点:
- 子进程拥有自己的地址空间、寄存器和程序计数器。
- 父子进程共享相同的代码内容,但数据、堆、栈是逻辑独立的。
fork()在子进程中返回 0,在父进程中返回子进程 PID。- 父子进程执行顺序不确定,由调度器决定。
易错点:fork() 不是“从 main 重新开始执行”,而是从 fork() 调用返回处继续执行。
3. wait()
wait() 让父进程等待子进程状态变化,常见情况是等待子进程结束。
作用:
- 让输出顺序更确定。
- 回收子进程退出状态。
- 避免子进程长期处于僵尸状态。
如果父进程先运行并调用 wait(),它会阻塞,直到子进程终止。
4. exec()
exec() 用于在当前进程中加载并运行一个新的可执行程序。
关键点:
exec()不创建新进程。- 成功后,当前进程的代码、静态数据、堆、栈、寄存器和 PC 都被新程序替换。
exec()成功后不会返回到原程序后续代码。
fork() 和 exec() 的区别:
| 调用 | 是否创建新进程 | 作用 |
|---|---|---|
fork() |
是 | 复制当前进程,产生父子进程 |
exec() |
否 | 用新程序替换当前进程映像 |
5. 为什么 UNIX/Linux 分离 fork() 和 exec()
Shell 通常采用 fork() + exec() 启动命令。
这样设计的好处是:Shell 在 fork() 之后、exec() 之前可以对子进程环境做准备,例如:
- I/O 重定向:关闭
STDOUT,再打开目标文件,使新文件获得文件描述符 1。 - 管道:用
pipe()把一个进程的输出连接到另一个进程的输入。 - 后台运行:父 Shell 不等待子进程,继续接收命令。
STDIN 是 Standard Input,标准输入,文件描述符 0。
STDOUT 是 Standard Output,标准输出,文件描述符 1。
STDERR 是 Standard Error,标准错误,文件描述符 2。
IPC 是 Inter-Process Communication,全称进程间通信。
6. 进程终止与资源回收
进程结束后,操作系统需要回收:
- 物理内存或虚拟内存映射。
- 打开的文件描述符。
- PCB 和调度队列中的记录。
- 子进程退出状态。
如果子进程结束但父进程未回收,子进程会短暂成为 zombie。
三、受限直接执行机制 LDE
LDE 是 Limited Direct Execution,全称受限直接执行。
它解决 CPU 虚拟化中的两个问题:
- 性能:程序大部分时间直接在 CPU 上运行,避免每条指令都由操作系统解释。
- 控制:通过硬件特权级、中断、异常和系统调用,保证操作系统能限制危险操作并收回 CPU。
1. 用户态与内核态
用户模式(User Mode):
- 普通应用程序运行在用户态。
- 不能直接执行特权指令。
- 不能直接访问任意硬件和内核内存。
内核模式(Kernel Mode):
- 操作系统内核运行在内核态。
- 可以执行特权指令。
- 可以访问硬件资源和内核数据结构。
这种模式隔离保证应用程序不能随便破坏系统。
2. 系统调用与 trap
系统调用(System Call)是用户程序请求内核服务的受控入口,例如文件 I/O、进程创建、内存映射。
trap 是陷入。用户程序执行 trap 指令后:
- CPU 从用户态切到内核态。
- 保存必要现场,例如 PC、标志寄存器、部分通用寄存器。
- 跳转到内核中预先注册的处理函数。
- 内核完成服务。
- 执行 return-from-trap,恢复用户现场并切回用户态。
x86 中常见系统调用相关指令:
INT:Interrupt,中断指令,早期系统调用入口。SYSCALL:x86-64 快速系统调用指令。IRET:Interrupt Return,中断返回。SYSRET:System Call Return,系统调用返回。
3. Trap Table、IDT、IVT
Trap Table 是陷阱表,也可理解为异常、中断、系统调用的处理程序入口表。
IDT 是 Interrupt Descriptor Table,全称中断描述符表。现代 x86 保护模式下,CPU 根据中断向量号在 IDT 中找到处理函数入口。
IDTR 是 Interrupt Descriptor Table Register,全称中断描述符表寄存器,用于保存 IDT 的地址和界限。
IVT 是 Interrupt Vector Table,全称中断向量表。x86 实模式中,IVT 位于低地址,共 256 项。
中断向量号(Interrupt Vector Number)用于区分事件类型,例如除零、时钟中断、系统调用。
4. 中断、异常、trap、fault、abort
中断(Interrupt)通常是异步硬件事件,例如键盘输入、磁盘 I/O 完成、时钟中断。
异常(Exception)通常由当前执行指令触发,例如除零、非法地址访问。
x86 中异常常分为:
- Trap:处理后继续执行下一条指令。
- Fault:处理后重新执行导致异常的指令,例如缺页异常。
- Abort:严重错误,通常无法可靠恢复。
5. 操作系统如何重新获得 CPU 控制权
合作式方式:
- 进程主动发起系统调用,例如
yield()。 - 进程执行非法操作导致异常。
- 问题:如果进程陷入无限循环且不系统调用,操作系统可能无法及时收回 CPU。
非合作式方式:
- 使用时钟中断(Timer Interrupt)。
- 硬件定期触发中断,CPU 进入内核。
- 内核时钟中断处理程序调用调度器,必要时抢占当前进程。
PIT 是 Programmable Interval Timer,全称可编程间隔定时器,是早期 x86 上产生周期性时钟中断的硬件。
6. 上下文切换
上下文切换(Context Switch)是操作系统从一个进程切换到另一个进程的过程。
基本步骤:
- 保存当前进程上下文:PC、寄存器、SP、状态等。
- 把上下文写入当前进程 PCB。
- 调度器选择下一个进程。
- 恢复下一个进程上下文。
- 必要时切换地址空间,例如切换页表基址寄存器。
- 返回用户态执行新进程。
上下文切换的开销不仅是保存寄存器,还包括缓存、TLB 和分支预测状态受到影响。
7. 中断处理中的并发问题
如果内核正在处理中断,又来了另一个中断,可能破坏内核数据结构。常见处理方法:
- 在关键中断处理期间禁用中断。
- 使用锁保护共享内核数据结构。
CLI 是 Clear Interrupt Flag,全称清除中断标志,常用于禁用可屏蔽中断。
STI 是 Set Interrupt Flag,全称设置中断标志,常用于重新启用中断。
四、进程调度
调度器(Scheduler)根据调度策略(Scheduling Policy)决定哪个就绪进程获得 CPU。
1. 调度目标与指标
不同系统重视不同指标:
- 吞吐量(Throughput):单位时间完成的任务数。
- CPU 利用率(CPU Utilization):CPU 忙于有效工作的比例。
- 周转时间(Turnaround Time):完成时间 - 到达时间。
- 平均周转时间 ATT(Average Turnaround Time):所有周转时间的平均值。
- 响应时间(Response Time):到达后到第一次被调度或第一次产生输出的时间。
- 平均响应时间 ART(Average Response Time):所有响应时间的平均值。
- 公平性(Fairness):各进程获得合理 CPU 机会。
常用数学表达式:
$$ \begin{gathered} X = \frac{N}{T} \ U = \frac{B}{T} \ T_i = C_i - A_i \ ATT = \frac{1}{n}\sum_{i=1}^{n}T_i \ R_i = F_i - A_i \ ART = \frac{1}{n}\sum_{i=1}^{n}R_i \ W_i = T_i - S_i \ NTT_i = \frac{T_i}{S_i} \ F = \frac{\min_i Q_i}{\max_i Q_i} \end{gathered} $$
符号说明:X 为吞吐量;N 为完成任务数;T 为总时间;U 为 CPU 利用率;B 为 CPU 忙碌时间;T_i 为作业 i 的周转时间;C_i 为完成时间;A_i 为到达时间;ATT 为平均周转时间;R_i 为响应时间;F_i 为首次运行时间;ART 为平均响应时间;W_i 为等待时间;S_i 为实际运行时间;NTT_i 为带权周转时间;F 为公平性比值;Q_i 为进程 i 获得的 CPU 时间或资源份额。
性能和公平性经常冲突:极端优化平均周转时间可能让长作业饥饿;极端公平可能降低短作业体验。
2. FCFS/FIFO
FCFS 是 First-Come, First-Served,全称先来先服务。
FIFO 是 First-In, First-Out,全称先进先出。FCFS 通常用 FIFO 队列实现。
特点:
- 非抢占式。
- 实现简单。
- 如果长作业排在前面,短作业必须等待,产生护航效应。
Convoy Effect 是护航效应,指短任务排在长任务后面导致整体平均周转时间变差。
3. SJF
SJF 是 Shortest Job First,全称最短作业优先。
思想:先运行预计执行时间最短的作业。
特点:
- 非抢占式。
- 所有作业同时到达且运行时间已知时,平均周转时间最优。
- 现实难点是运行时间通常未知。
- 长作业可能饥饿。
4. STCF/PSJF
STCF 是 Shortest Time-to-Completion First,全称最短完成时间优先。
PSJF 是 Preemptive Shortest Job First,全称抢占式最短作业优先。
思想:每次调度时选择剩余运行时间最短的进程。新进程到达时,如果它的剩余时间更短,可以抢占当前进程。
优点:在关注平均周转时间时效果好。
缺点:对响应时间不一定好,长作业可能长期得不到运行。
5. RR
RR 是 Round Robin,全称轮转调度,也叫时间片调度(Time-Slicing Scheduling)。
思想:每个进程运行一个时间片 q,到期后切换到队列下一个进程。
特点:
- 公平。
- 响应时间较好,适合分时系统和交互系统。
- 时间片太短,上下文切换开销占比高。
- 时间片太长,响应时间变差,接近 FCFS。
时间片设计要权衡响应性和调度开销。
RR 中常考调度开销比例:
$$ \begin{gathered} O_r = \frac{O}{q+O} \ E = \frac{q}{q+O} \end{gathered} $$
符号说明:$O_r$ 为调度开销比例;O 为每个时间片对应的调度开销;q 为时间片长度;E 为有效 CPU 时间比例。
6. I/O 与调度
I/O 是 Input/Output,全称输入/输出。
当进程发起 I/O:
- 进程进入阻塞态。
- 调度器应运行其他就绪进程,避免 CPU 空闲。
- I/O 完成后设备发出中断。
- 内核把进程从阻塞态改为就绪态。
I/O 密集型进程经常短暂运行后阻塞;CPU 密集型进程长时间占用 CPU。调度器通常希望兼顾二者。
五、MLFQ 与比例份额调度
1. MLFQ
MLFQ 是 Multilevel Feedback Queue,全称多级反馈队列。
CTSS 是 Compatible Time-Sharing System,全称兼容分时系统。MLFQ 思想可追溯到早期分时系统。
MLFQ 的目标:
- 在不知道作业长度的情况下近似 SJF/STCF。
- 优先照顾交互型、短作业特征的进程,降低响应时间。
- 根据进程过去的 CPU 使用行为动态调整优先级。
基本规则:
- 如果 Priority(A) > Priority(B),运行 A。
- 如果 Priority(A) = Priority(B),同队列内使用 RR。
- 新进程进入系统时放入最高优先级队列。
- 进程在某队列中消耗完整时间配额后,优先级降低。
- 每隔一段时间 S,把所有进程提升到最高优先级队列。
MLFQ 的直觉:
- 交互型进程经常在时间片用完前等待 I/O,因此保持高优先级,响应快。
- CPU 密集型进程经常用完整个时间片,因此逐步降级。
MLFQ 的问题和修正:
- 饥饿:高优先级交互进程太多时,低优先级长作业可能一直等。解决方法是周期性优先级提升。
- 行为变化:进程可能从 CPU 密集变成 I/O 密集。优先级提升可以让它重新获得机会。
- 欺骗调度器:进程在时间片快用完前主动 I/O,避免降级。解决方法是累计某队列中总 CPU 使用量,而不是只看一次是否用完整个时间片。
2. nice 值
nice 是 UNIX/Linux 中影响普通进程调度权重的机制。
nice 值通常范围为 -20 到 +19:
- nice 值越小,优先级越高,权重越大。
- nice 值越大,优先级越低,权重越小。
renice 可以修改运行中进程的 nice 值。
3. 比例份额调度
比例份额调度也叫公平份额调度(Fair-Share Scheduling),目标是保证每个进程获得一定比例的 CPU 时间,而不一定优化周转时间或响应时间。
比例份额目标可写成:
$$ \begin{gathered} s_i = \frac{t_i}{\sum_j t_j} \ C_i \approx C_{total} \cdot s_i \end{gathered} $$
符号说明:s_i 为进程 i 的 CPU 份额;t_i 为进程 i 的彩票数;Σ t_j 为所有进程彩票总数;C_i 为进程 i 获得的 CPU 时间;C_{total} 为总 CPU 时间。
4. 彩票调度
彩票调度(Lottery Scheduling)用随机抽奖实现比例份额。
思想:
- 每个进程持有若干张彩票。
- 每个时间片随机抽一张中奖彩票。
- 持有中奖彩票的进程运行。
- 长期看,进程获得 CPU 的比例接近其彩票比例。
例:A 有 75 张票,B 有 25 张票,则长期 A 约获得 75% CPU,B 约获得 25% CPU。
相关机制:
- 彩票货币(Ticket Currency):用户可以用自己的局部货币分配给进程,系统换算成全局彩票。
- 彩票转让(Ticket Transfer):一个进程临时把彩票转给另一个进程,适合客户端-服务器场景。
- 彩票通胀(Ticket Inflation):进程临时增加或减少彩票数量,但需要信任环境,否则可能滥用。
优点:简单、随机化可避免某些边界情况。
缺点:短时间内可能不公平,票数如何分配也是问题。
5. 步长调度
步长调度(Stride Scheduling)是确定性的公平份额调度。
基本公式:
$$ \begin{gathered} l_i = \frac{L}{t_i} \ p_i' = p_i + l_i \ k = \arg\min_i p_i \end{gathered} $$
符号说明:l_i 为进程 i 的步长;L 为足够大的常数;t_i 为进程 i 的票数;p_i 为进程 i 当前 pass 值;p_i' 为运行一次后的 pass 值;k 为下一个被调度的进程。
每个进程维护 pass 值:
- 选择 pass 值最小的进程运行。
- 运行后,
p_i' = p_i + l_i。 - 票越多,stride 越小,pass 增长越慢,因此更频繁被选中。
优点:比彩票调度更确定,短期公平性更好。
缺点:新进程如果 pass 初值处理不当,可能暂时垄断 CPU。
6. CFS
CFS 是 Completely Fair Scheduler,全称完全公平调度器,是 Linux 的普通进程调度器思想。
核心概念:
- vruntime 是 Virtual Runtime,全称虚拟运行时间。
- 调度器总是选择 vruntime 最小的进程运行。
- nice 值映射为权重,权重高的进程 vruntime 增长更慢,因此更频繁运行。
- 可运行进程按 vruntime 放入红黑树。
RB Tree 是 Red-Black Tree,全称红黑树。它是自平衡二叉搜索树,插入、删除、查找复杂度通常为 O(log n)。CFS 取最左节点作为 vruntime 最小的进程。
常见参数:
sched_latency:调度延迟,表示一轮公平调度周期的目标长度。min_granularity:最小调度粒度,避免进程很多时每个时间片过小。
近似公式:
$$ \begin{gathered} time_slice(process) = sched_latency \cdot weight(process) / sum(weights) \ vruntime += actual_runtime \cdot 1024 / weight(process) \end{gathered} $$
权重越大,实际时间片越长,vruntime 增长越慢。
六、多处理器调度
1. 多核与线程
多核处理器(Multicore Processor)是在同一芯片上集成多个 CPU 核心。核心变多不会自动让单线程程序更快;程序需要通过线程(Threads)或多进程并行才能利用多个核心。
LWP 是 Light Weight Process,全称轻量级进程。在 Linux 工具输出中,LWP 常用于表示内核调度实体,也就是线程。
2. Cache 与局部性
Cache 是缓存,是小而快的硬件存储器,用于保存主存中常用数据副本。
局部性:
- 时间局部性(Temporal Locality):最近访问过的数据或指令,短期内可能再次访问。
- 空间局部性(Spatial Locality):访问某地址后,附近地址也可能很快被访问。
3. 缓存一致性
缓存一致性(Cache Coherence)要求多个 CPU 缓存中同一共享数据的副本保持一致。
问题例子:
- CPU0 和 CPU1 都缓存了地址 X 的旧值。
- CPU0 修改 X,但 CPU1 缓存未更新。
- CPU1 再读 X 时可能读到旧值。
常见硬件方案是总线嗅探(Bus Snooping):缓存监听总线上的读写事务,一旦发现其他 CPU 修改了自己缓存的共享块,就使本地副本失效或更新。
4. 同步
Synchronization 是同步。多核系统中多个 CPU 可能同时访问共享数据,必须使用互斥机制保证正确性。
Mutex 是 Mutual Exclusion,全称互斥锁。锁保护临界区,防止多个线程同时修改共享结构。
5. 缓存亲和性
缓存亲和性(Cache Affinity)指尽量让同一进程/线程继续在同一个 CPU 上运行。
原因:进程上次运行留下的缓存数据可能仍在该 CPU 的缓存中,再次在同一 CPU 上运行会更快。频繁迁移到其他 CPU 会导致缓存失效和更多 Cache Miss。
Cache Miss 是缓存未命中。
6. 单队列多处理器调度
单队列多处理器调度(Single-Queue Multiprocessor Scheduling)把所有可运行任务放入一个全局队列,多个 CPU 从同一个队列取任务。
优点:
- 实现简单。
- 全局负载比较容易平衡。
缺点:
- 多 CPU 访问共享队列需要加锁,可扩展性差。
- 任务可能频繁迁移,缓存亲和性差。
7. 多队列多处理器调度
多队列多处理器调度(Multi-Queue Multiprocessor Scheduling)为每个 CPU 维护本地运行队列。
优点:
- 减少共享队列锁竞争,可扩展性更好。
- 更容易保持缓存亲和性。
缺点:
- 各队列可能负载不均。
- 需要任务迁移(Migration)或工作窃取来做负载均衡。
负载均衡要在两件事之间权衡:
- 迁移任务能提高 CPU 利用率。
- 迁移任务会损失缓存亲和性并带来迁移开销。
七、内存虚拟化与地址空间
1. 内存虚拟化
Memory Virtualization 是内存虚拟化。操作系统和硬件共同为每个进程提供独立的虚拟地址空间,使进程看起来像独占一整块连续内存。
关键硬件:
- MMU:Memory Management Unit,全称内存管理单元,负责地址转换和权限检查。
- TLB:Translation Lookaside Buffer,全称转换后备缓冲,用于缓存地址转换结果。
内存虚拟化的优势:
- 易用性:程序使用连续虚拟地址,不需要直接管理物理地址。
- 效率:按需加载、共享代码、交换到磁盘,提高内存利用率。
- 保护:隔离进程和内核,防止非法访问。
虚拟内存系统目标:
- 透明性(Transparency):进程感觉自己拥有独立内存。
- 效率(Efficiency):时间和空间开销可接受。
- 保护与隔离(Protection and Isolation):非法访问会被阻止。
2. 虚拟地址与物理地址
VA 是 Virtual Address,全称虚拟地址。进程生成的地址都是虚拟地址。
PA 是 Physical Address,全称物理地址。真实内存硬件使用物理地址。
地址转换(Address Translation)是把 <pid, virtual address> 映射到 physical address 的过程。进程不能直接访问物理地址。
地址转换带来四个重要能力:
- 保护:不同进程映射到不同物理内存区域。
- 重定位:进程可加载到任意物理位置,虚拟地址不变。
- 数据共享:不同进程的虚拟页可映射到同一物理页。
- 多路复用:有限物理内存可在不同时间服务不同虚拟页。
八、内存操作 API 与空闲空间管理
1. 栈与堆
栈:
- 存放函数参数、返回地址、局部变量。
- 生命周期短,随函数调用自动分配和释放。
- 由编译器和调用约定隐式管理。
堆:
- 存放动态分配对象。
- 生命周期由程序员控制。
- 通过
malloc()、free()、calloc()、realloc()等 API 管理。 - 易出现内存泄漏、悬空指针等错误。
2. malloc()
malloc() 在堆上分配指定字节数。
void *malloc(size_t size);
size_t 是无符号整数类型,用于表示对象大小。
返回值:
- 成功:返回指向内存块的
void *指针。 - 失败:返回
NULL。
建议用 sizeof() 计算大小,避免硬编码:
int *a = malloc(n * sizeof(int));
字符串分配要给结尾空字符 \0 留空间:
char *s = malloc(strlen(src) + 1);
3. free()
free() 释放由 malloc()、calloc() 或 realloc() 返回的堆内存。
void free(void *ptr);
注意:
- 只能释放堆上分配得到的指针。
free(NULL)是安全的,但无实际效果。- 释放后指针本身不会自动变成
NULL,可能成为悬空指针。
4. calloc() 与 realloc()
calloc() 分配数组并清零:
void *calloc(size_t num, size_t size);
realloc() 调整已分配内存块大小:
void *realloc(void *ptr, size_t size);
realloc() 可能原地扩展,也可能移动到新地址。失败返回 NULL,原内存块仍有效,因此实际代码中不要直接覆盖原指针。
5. 常见内存错误
- 未初始化指针:把未定义地址当作目标地址写入。
- 分配不足:例如忘记字符串结尾
\0。 - 未初始化读取:读取未赋值内存。
- 内存泄漏(Memory Leak):分配的内存失去引用且未释放。
- 悬空指针(Dangling Pointer):指向已经释放或失效对象。
- 双重释放(Double Free):同一块内存释放两次。
- 无效释放(Invalid Free):释放栈变量、未初始化指针或非分配起始地址。
Valgrind 的 Memcheck 可检测内存泄漏、无效访问、未初始化使用等问题。
6. brk/sbrk 与 mmap
brk() 设置进程的 program break,即数据段末尾位置。
sbrk() 相对移动 program break。
现代程序通常不直接调用 brk()/sbrk(),而是使用 malloc()/free()。现代分配器也会用 mmap() 处理大块或特殊分配。
mmap() 用于在进程地址空间中建立内存映射,可映射文件或匿名内存。
7. 空闲空间管理
Free-Space Management 是空闲空间管理。目标是在可变大小内存块中快速分配、释放,并尽量减少碎片。
两类碎片:
- 内部碎片(Internal Fragmentation):已分配块内部有未使用空间。
- 外部碎片(External Fragmentation):空闲总量足够,但分散成小块,无法满足大请求。
碎片指标可写成:
$$ \begin{gathered} I = A - R \ I_r = \frac{I}{A} \ E = \sum f_i \ M = \max(f_i) \ 外部碎片 \Longleftrightarrow E \ge R \land M < R \end{gathered} $$
符号说明:I 为内部碎片大小;I_r 为内部碎片率;A 为实际分配块大小;R 为请求大小;E 为空闲空间总量;f_i 为第 i 个空闲块大小;M 为最大空闲块大小。
8. 分割、合并与头部
Splitting 是分割:找到比请求更大的空闲块,把它切成“已分配部分”和“剩余空闲部分”。
Coalescing 是合并:释放后如果相邻块都是空闲块,就合并为更大空闲块,减少外部碎片。
free(ptr) 没有大小参数,分配器通常在用户指针前保存 header:
- 块大小。
- magic number,用于完整性检查。
- 可能包含链表指针。
释放时,分配器通过 ptr 向前找到 header,从而知道释放范围。
9. 空闲链表策略
Best Fit,全称最佳适配:
- 找到能容纳请求的最小空闲块。
- 试图减少浪费,但可能产生很多很小碎片。
Worst Fit,全称最坏适配:
- 找最大空闲块进行分割。
- 试图留下较大的剩余块,但通常需要遍历,效果不一定好。
First Fit,全称首次适配:
- 从链表头开始找第一个足够大的块。
- 速度较快,但前部容易碎片化。
Next Fit,全称下次适配:
- 从上次查找结束位置继续找。
- 减少从头反复扫描的偏向。
10. 分离列表、Slab 与伙伴分配
Segregated Lists 是分离列表:按大小类维护多个空闲链表,例如 8B、16B、32B。常用于频繁分配固定大小对象。
Slab Allocator 是 Slab 分配器:为常见内核对象维护缓存,例如锁、inode 等。对象重复创建和销毁时可复用初始化好的内存。
Buddy Allocation 是伙伴分配。它把内存按 2 的幂大小管理:
- 请求到来时,找到能容纳请求的最小 2 的幂块。
- 如果块太大,就不断对半分裂。
- 释放时,如果伙伴块也空闲,就合并。
优点:合并简单。
缺点:可能产生内部碎片。
九、基址-界限与分段
1. 动态重定位
Dynamic Relocation 是动态重定位。最简单硬件机制是 base and bound,即基址加界限。
硬件寄存器:
- Base Register:基址寄存器,保存进程虚拟地址 0 对应的物理起始地址。
- Bounds Register:界限寄存器,保存地址空间大小或结束边界。
地址转换:
$$ \begin{gathered} 0 \le v < L \Rightarrow p = B + v \ v \ge L \Rightarrow \text{trap} \end{gathered} $$
符号说明:v 为虚拟地址;L 为界限寄存器值;p 为物理地址;B 为基址寄存器值;trap 表示越界异常。
优点:
- 实现简单。
- 支持重定位和保护。
缺点:
- 每个进程需要连续物理内存。
- 地址空间中未使用区域也占着物理范围,容易产生内部碎片。
上下文切换时,操作系统要保存和恢复 base/bound 寄存器。
2. 分段
Segmentation 是分段。它是基址-界限机制的泛化:不是给整个地址空间一对 base/bound,而是给每个逻辑段一对 base/bound。
典型段:
- 代码段。
- 数据段。
- 堆段。
- 栈段。
每个段在物理内存中各自连续,但不同段之间不必相邻。
地址转换需要确定:
- 段号(Segment Number)。
- 段内偏移(Offset)。
- 对应段的 base、bound 和权限。
物理地址:
$$ p = B_s + d $$
符号说明:p 为物理地址;B_s 为段 s 的基址;d 为段内偏移。前提是 0 ≤ d < L_s,且访问权限合法;L_s 为段 s 的界限。
3. 如何确定段号
显式方式:
- 用虚拟地址高几位表示段号。
- 剩余位表示段内偏移。
隐式方式:
- 根据访问类型判断段。
- 例如取指访问代码段,栈指针相关访问栈段。
显式方式简单,但段号位可能浪费,且偏移位数限制段最大大小。
4. 栈段反向增长
栈通常向低地址增长。硬件需要知道段增长方向。
对反向增长段,地址转换可能要使用负偏移:
$$ \begin{gathered} d' = d - M \ p = B_s + d' \end{gathered} $$
符号说明:d' 为反向增长段使用的负偏移;d 为地址中给出的偏移;M 为该段最大大小;p 为物理地址;B_s 为段基址。
5. 分段的共享与保护
段可以共享。例如多个进程的代码段可以映射到同一个物理位置,节省内存。
段表项通常包含保护位:
- R:Read,读权限。
- W:Write,写权限。
- X:Execute,执行权限。
非法访问会触发段错误(Segmentation Fault)。
6. 分段的问题
分段减少了基址-界限的内部碎片,但引入外部碎片。因为段大小可变,物理内存中可能出现很多零散空洞。
解决思路:
- 内存压缩(Memory Compaction):移动段,合并空闲空间。代价高,需要暂停进程、复制数据、更新段寄存器。
- 空闲链表算法:Best Fit、Worst Fit、Buddy 等。
十、分页
1. 分页概念
Paging 是分页。它把虚拟地址空间切成固定大小的页(Page),把物理内存切成同样大小的页框(Page Frame)。
每个进程有页表(Page Table),记录虚拟页到物理页框的映射。
优点:
- 不要求进程在物理内存中连续。
- 空闲空间管理简单,按固定页框分配。
- 支持稀疏地址空间和灵活映射。
缺点:
- 页表可能很大。
- 每次地址转换可能需要额外访存。
- 页内部可能有内部碎片。
2. 虚拟地址划分
VPN 是 Virtual Page Number,全称虚拟页号。
Offset 是页内偏移。
PFN 是 Physical Frame Number,全称物理页框号。
页大小为 2^n 字节时:
$$ \begin{gathered} b = n \ v = a - b \ PA = (PFN << b) | d \end{gathered} $$
符号说明:b 为页内偏移位数;n 为页面大小的指数;v 为 VPN 位数;a 为虚拟地址位数;PA 为物理地址;PFN 为物理页帧号;d 为页内偏移。
页表负责把 VPN 映射到 PFN。
例:32 位虚拟地址,页大小 4KB:
- 4KB = 2^12,所以 offset 为 12 位。
- VPN 为 32 - 12 = 20 位。
- 线性页表有 2^20 个页表项。
3. 页表项 PTE
PTE 是 Page Table Entry,全称页表项。
常见字段:
- PFN:Physical Frame Number,物理页框号。
- Valid Bit:有效位,表示该虚拟页映射是否合法。
- Present Bit:存在位,表示页面当前是否在物理内存中。
- Protection Bit:保护位,控制读/写/执行权限。
- Dirty Bit:脏位,表示页面载入后是否被修改。
- Reference Bit 或 Accessed Bit:引用位/访问位,表示页面是否被访问过。
x86 常见 PTE 标志:
- P:Present,存在位。
- R/W:Read/Write,读写位。
- U/S:User/Supervisor,用户/超级用户权限位。
- A:Accessed,访问位。
- D:Dirty,脏位。
4. PTBR 与分页开销
PTBR 是 Page Table Base Register,全称页表基址寄存器,保存当前进程页表起始地址。
最基本分页中,每次访问内存可能需要两次内存访问:
- 访问页表,读取 PTE。
- 根据 PFN + offset 访问真实数据或指令。
所以分页若没有 TLB,会显著变慢。
5. 页表大小计算
公式:
$$ \begin{gathered} N_p = V / P \ S_{PT} = N_p \cdot S_{PTE} \ b = \log_2(P) \ v = a - b \ N_{PTE} = 2^v \ S_{PT} = N_{PTE} \cdot S_{PTE} \end{gathered} $$
符号说明:$N_p$ 为虚拟页数;V 为虚拟地址空间大小;$P$ 为页大小;$S_{PT}$ 为页表大小;$S_{PTE}$ 为单个 PTE 大小;b 为页内偏移位数;v 为 VPN 位数;a 为虚拟地址位数;$N_{PTE}$ 为页表项数量。
例:32 位地址空间,4KB 页,4B PTE:
$$ \begin{gathered} N_p = 2^32 / 2^12 = 2^20 \ S_{PT} = 2^20 \cdot 4B = 4\text{MB} \end{gathered} $$
注意:这是每个进程一张页表的大小。如果系统中有很多进程,页表内存开销很大。
十一、TLB 快速地址转换
1. TLB 基本作用
TLB 是 Translation Lookaside Buffer,全称转换后备缓冲。它是 MMU 中或与 MMU 协同工作的硬件缓存,用来缓存 VPN -> PFN 的地址转换结果。(系统级)
TLB 相关指标:
$$ \begin{gathered} h = \frac{H}{N} \ m = \frac{M}{N} \ h + m = 1 \ EAT = h \cdot C_h + m \cdot C_m \end{gathered} $$
符号说明:h 为 TLB 命中率;m 为 TLB 未命中率;H 为命中次数;M 为未命中次数;N 为地址转换总次数;EAT 为有效地址转换代价;$C_h$ 为命中代价;$C_m$ 为未命中代价。
TLB 命中流程:
- CPU 生成虚拟地址。
- 硬件提取 VPN。
- 查 TLB。
- 若命中,取出 PFN。
- 拼接 PFN 和 offset,访问物理内存。
TLB 未命中流程:
- 查页表。
- 如果 PTE 有效且权限合法,把映射插入 TLB。
- 重新执行原指令。
- 如果 PTE 无效或页面不在内存,触发异常,例如 page fault。
2. TLB 为什么有效
因为程序具有局部性:
- 时间局部性:最近访问过的页可能再次访问。
- 空间局部性:同一页内相邻地址可能连续访问。
例如顺序访问数组时,同一页内多个元素共享同一个 VPN -> PFN 映射。第一次访问某页 TLB miss,后续访问同页元素可能 hit。
3. TLB 未命中由谁处理
硬件管理 TLB(Hardware-Managed TLB):
- 硬件知道页表结构。
- TLB 未命中时硬件自动遍历页表。
- 若 PTE 有效,则填入 TLB。
- 若无效或权限错误,触发异常给 OS。
软件管理 TLB(Software-Managed TLB):
- 硬件在 TLB 未命中时触发异常。
- OS 的异常处理程序查页表并填 TLB。
- 常见于一些 RISC 架构。
RISC 是 Reduced Instruction Set Computer,全称精简指令集计算机。
4. TLB 项内容
TLB Entry 通常包含:
- VPN。
- PFN。
- Valid Bit。
- Protection Bits。
- ASID。
ASID 是 Address Space Identifier,全称地址空间标识符。它用于区分不同进程的同一 VPN。
没有 ASID 时,上下文切换后,旧进程的 TLB 项可能被新进程误用。因此系统可能需要 flush TLB,即清空 TLB。ASID 可以减少上下文切换时的 TLB 清空开销。
5. TLB 替换策略
TLB 容量有限,未命中后插入新项时可能需要淘汰旧项。
LRU 是 Least Recently Used,全称最近最久未使用。它淘汰最长时间没有被访问的项,利用局部性减少 miss。
也可以使用随机替换或近似策略,降低硬件实现复杂度。
十二、较小的页表
1. 为什么线性页表太大
线性页表为整个虚拟地址空间预留 PTE,即使大部分虚拟页未使用也占空间。
直接增大页面大小可以减少页表项数量,但会带来:
- 更严重的内部碎片。
- 换入换出粒度变大。
- 可能浪费 I/O。
因此需要更好的页表压缩方法。
2. 分页分段结合
分页分段结合的思想:每个逻辑段单独维护页表,而不是整个虚拟地址空间一张页表。
段表项中:
- base 不再指向段本身,而是指向该段页表的物理地址。
- bound 表示该段页表长度或段界限。
地址转换流程:
- 从虚拟地址取段号 SN(Segment Number)。
- 查段表,得到该段页表基址和界限。
- 检查 VPN 是否越界。
- 根据
Base[SN] + VPN * sizeof(PTE)找 PTE。 - 取 PFN,与 offset 拼接成物理地址。
优点:
- 不为未使用的大段间空洞分配页表。
- 相比单级线性页表节省空间。
缺点:
- 如果某个段很大但使用稀疏,段内页表仍可能浪费。
- 同时维护段表和多个页表,复杂度更高。
3. 多级页表
多级页表把线性页表拆成树状结构,只为实际使用的虚拟地址范围分配下级页表页。
PDE 是 Page Directory Entry,全称页目录项。
PDIndex 是 Page Directory Index,全称页目录索引。
PTIndex 是 Page Table Index,全称页表索引。
PDBR 是 Page Directory Base Register,全称页目录基址寄存器。
两级页表思路:
- 一级页目录由 PDE 组成。
- 每个 PDE 指向一个二级页表页。
- 如果某个虚拟地址范围没有有效页,PDE 无效,对应二级页表页不分配。
PTE 地址计算:
$$ PTEAddr = (PDE.PFN << SHIFT) + PTIndex \cdot sizeof(PTE) $$
多级页表优点:
- 按实际使用地址范围分配页表空间。
- 页表页不需要物理连续,扩展方便。
多级页表缺点:
- 地址翻译可能需要多次访存,是典型时间-空间权衡。
- 实现更复杂。
- 依赖 TLB 降低多次查表成本。
4. 多级页表计算套路
给定虚拟地址位数、页面大小、PTE 大小:
b = log2(P)。v = a - b。- $e = P / S_{PTE}$。
p = log2(e)。d = v - p。
符号说明:b 为页内偏移位数;P 为页大小;v 为 VPN 位数;a 为虚拟地址位数;e 为一个页表页可容纳的 PTE 数;S_{PTE} 为单个 PTE 大小;p 为页表索引位数;d 为页目录索引位数。
例:32 位地址,4KB 页,4B PTE:
- offset = 12 位。
- VPN = 20 位。
- 每页表页 4096 / 4 = 1024 = 2^10 项。
- PTIndex = 10 位。
- PDIndex = 10 位。
- 地址划分:10 位页目录索引 + 10 位页表索引 + 12 位偏移。
5. 倒排页表
Inverted Page Table 是倒排页表。
普通页表:每个进程一张表,每个 PTE 对应一个虚拟页。
倒排页表:整个系统一张表,每个 PTE 对应一个物理页框。表项记录:
- 哪个进程正在使用该物理页。
- 该物理页对应进程的哪个虚拟页。
优点:
- 表大小与物理内存大小相关,而不是与所有进程虚拟地址空间总量相关。
- 可显著节省页表空间。
缺点:
- 地址转换查找更复杂,通常需要哈希表或 TLB 辅助。
- 不在内存中的页面仍需要其他结构记录磁盘位置。
十三、超越物理内存:交换机制
1. 为什么需要交换
物理内存有限,但进程虚拟地址空间可能很大,系统中也可能同时运行许多进程。
Swapping Mechanism 是交换机制。操作系统在磁盘上预留交换空间(Swap Space),把不活跃页面换出到磁盘,需要时再换入内存。
内存层次:
- Register,寄存器:最快、最小。
- Cache,缓存:快、小。
- Main Memory,主存/RAM:容量较大、速度适中。
- Mass Storage,大容量存储/磁盘:容量大、慢。
RAM 是 Random Access Memory,全称随机访问存储器。
2. 交换空间与存在位
Swap Space 是交换空间,磁盘上用于保存被换出页面的区域。
Present Bit 是存在位:
- Present = 1:页面在物理内存中,PTE 包含 PFN。
- Present = 0:页面不在物理内存中,PTE 可能包含磁盘位置或其他状态。
3. 缺页异常
Page Fault 是缺页异常。当进程访问的页面不在物理内存中,硬件触发 page fault,陷入操作系统。
缺页处理流程:
- CPU 访问虚拟地址,查 TLB/页表。
- PTE 表明页面不在内存,触发 page fault。
- OS 检查访问是否合法。
- 根据 PTE 或补充结构找到页面在磁盘的位置。
- 找一个空闲物理页框。
- 若没有空闲页框,运行页面置换算法选择牺牲页。
- 若牺牲页是脏页,先写回磁盘。
- 从磁盘读入目标页。
- 更新 PTE,设置 Present Bit 和 PFN。
- 重新执行导致缺页的指令。
缺页异常属于 fault:处理后通常重新执行原指令。
4. 页面回收
操作系统通常不会等内存完全耗尽才回收页面,而是维护空闲页水位线。
Page Daemon 是页守护线程。Linux 中类似角色是 kswapd。
水位线:
- 低水位线:空闲页低于该值时,后台回收开始。
- 高水位线:回收到该值附近后,后台回收可停止。
提前回收可以减少前台缺页时的等待时间。
十四、页面置换策略
1. 目标与 AMAT
页面置换策略决定内存不够时淘汰哪个页面。目标是减少缺页次数,提高性能。
AMAT 是 Average Memory Access Time,全称平均内存访问时间。
简化理解:
$$ \begin{gathered} AMAT = H + mP \ m = \frac{F}{N} \ h = \frac{K}{N} \ h + m = 1 \ AMAT = M + fD \end{gathered} $$
符号说明:AMAT 为平均内存访问时间;H 为命中访问时间;m 为未命中率;P 为未命中惩罚;F 为缺页次数;N 为内存访问次数;h 为命中率;K 为命中次数;M 为内存访问时间;f 为缺页率;D 为缺页服务时间。
缺页代价很高,因为可能涉及磁盘 I/O。
2. OPT
OPT 是 Optimal Replacement,全称最优替换。
策略:淘汰未来最久才会再次访问的页面。
特点:
- 理论上缺页次数最少。
- 需要知道未来访问序列,实际系统无法实现。
- 常作为评价其他算法的基准。
3. FIFO
FIFO 是 First-In, First-Out,全称先进先出。
策略:淘汰最早进入内存的页面。
优点:
- 实现简单。
缺点:
- 不考虑页面是否热门。
- 可能淘汰正在频繁使用的页面。
- 可能出现 Belady 异常。
Belady 异常:在 FIFO 等某些算法中,页框数增加后缺页次数反而增加。
数学表达:
$$ B(k + 1) > B(k) $$
符号说明:B(k) 为 k 个页框时的缺页次数;若页框增加后缺页次数反而变大,就出现 Belady 异常。
4. Random
Random Replacement 是随机替换。
策略:随机选择一个页面淘汰。
优点:
- 实现简单。
- 不需要维护访问历史。
缺点:
- 性能不稳定。
- 可能淘汰高频访问页面。
5. LRU 与 LFU
LRU 是 Least Recently Used,全称最近最久未使用。
策略:淘汰最长时间没有被访问的页面。它利用短期局部性。
选择规则:
$$ v_{LRU} = \arg\min_p last(p) $$
符号说明:v_{LRU} 为 LRU 淘汰页;last(p) 为页 p 最近一次被访问的时间。
LFU 是 Least Frequently Used,全称最不经常使用。
策略:淘汰访问次数最少的页面。它关注长期访问频率。
选择规则:
$$ v_{LFU} = \arg\min_p count(p) $$
符号说明:$v_{LFU}$ 为 LFU 淘汰页;count(p) 为页 p 的访问次数。
精确 LRU 代价高,因为每次内存访问都要维护访问顺序或时间戳。实际系统常使用近似 LRU。
6. 引用位与时钟算法
Use Bit 或 Reference Bit 是引用位。页面被读、写或取指时,硬件把引用位置 1;操作系统在扫描或周期性检查时清 0。
Clock Algorithm 是时钟算法,是近似 LRU。
基本流程:
- 把候选页组织成循环列表。
- 时钟指针指向当前候选页。
- 如果引用位为 1,清 0,指针前进。
- 如果引用位为 0,选择该页淘汰。
时钟算法比精确 LRU 便宜,比完全不看历史的 FIFO/Random 通常更好。
7. 脏页与增强时钟
Dirty Bit 是脏位。页面被写过后,脏位置 1。
淘汰时:
- 干净页:可直接丢弃,因为磁盘或文件中已有相同内容。
- 脏页:必须写回磁盘或交换区,代价更高。
增强型时钟算法会优先选择“未被使用且干净”的页面,再考虑“未被使用但脏”的页面。
8. 预取、聚类和抖动
Prefetching 是预取。操作系统猜测某些页面即将被访问,提前调入内存。
Clustering 是聚类/分组。把多个待写回页面聚在一起,一次性发起较大磁盘 I/O,通常比多次小 I/O 更高效。
Thrashing 是抖动。系统频繁缺页,大部分时间都在换页,CPU 利用率显著下降。
可用指标表示为:
$$ \begin{gathered} f = \frac{F}{N} \ U = C / T \ D \cdot F \gg C \end{gathered} $$
符号说明:f 为缺页率;F 为缺页次数;N 为内存访问次数;U 为 CPU 利用率;C 为有效 CPU 工作时间;T 为总时间;D 为单次缺页服务时间;D · F >> C 表示系统大部分时间耗在换页上,容易发生抖动。
缓解抖动:
- 降低多道程序度,减少并发进程数量。
- 准入控制,暂缓启动新进程。
- OOM Killer 终止部分进程释放内存。
OOM 是 Out Of Memory,全称内存耗尽。
十五、常考计算与答题模板
1. 调度题
周转时间:
$$ \begin{gathered} T_i = C_i - A_i \ ATT = \frac{1}{n}\sum_i T_i \end{gathered} $$
响应时间:
$$ \begin{gathered} R_i = F_i - A_i \ ART = \frac{1}{n}\sum_i R_i \end{gathered} $$
符号说明:$T_i$ 为作业 i 的周转时间;$C_i$ 为完成时间;$A_i$ 为到达时间;ATT 为平均周转时间;$R_i$ 为响应时间;$F_i$ 为首次运行时间;ART 为平均响应时间;n 为作业数。
答题顺序:
- 画时间轴。
- 标出每个进程到达时间、运行时间、I/O 时间。
- 根据算法决定每个时间点运行谁。
- 算完成时间、周转时间、响应时间。
- 说明是否抢占、是否产生饥饿或护航效应。
2. 分页地址转换
给定虚拟地址 VA、页大小 P、页表:
$$ \begin{gathered} b = \log_2(P) \ VPN = VA \gg b \ d = VA \bmod P \ PFN = PT[VPN] \ PA = PFN \cdot P + d \end{gathered} $$
符号说明:b 为页内偏移位数;P 为页大小;VPN 为虚拟页号;d 为页内偏移;PT 为页表;PFN 为物理页帧号;PA 为物理地址。
若 PTE 无效:
- 地址非法:段错误或保护异常。
- 页面合法但不在内存:缺页异常。
3. 页表大小
$$ \begin{gathered} N_p = V / P \ S_{PT} = N_p \cdot S_{PTE} \end{gathered} $$
符号说明:N_p 为虚拟页数;V 为虚拟地址空间大小;P 为页大小;S_{PT} 为页表大小;S_{PTE} 为单个 PTE 大小。
二级页表:
$$ \begin{gathered} e = P / S_{PTE} \ p = \log_2(e) \ b = \log_2(P) \ v = a - b \ d = v - p \end{gathered} $$
符号说明:e 为一个页表页可容纳的 PTE 数;p 为页表索引位数;b 为页内偏移位数;v 为 VPN 位数;a 为虚拟地址位数;d 为页目录索引位数。
4. TLB 命中率
$$ \begin{gathered} h = \frac{H}{N} \ m = \frac{M}{N} \end{gathered} $$
符号说明:h 为 TLB 命中率;m 为 TLB 未命中率;H 为命中次数;M 为未命中次数;N 为访问或地址转换总次数。
顺序数组访问常利用空间局部性:同一页内多个元素只有第一次访问可能 miss。
5. 页面置换
页面置换题答题顺序:
- 写出访问串。
- 逐步维护页框内容。
- 每次访问标注 hit 或 fault。
- 按算法更新队列、引用位、脏位或时间戳。
- 统计缺页次数和命中率。
算法关键判断:
- FIFO:淘汰最早进入页框的页。
- LRU:淘汰最近最久未访问的页。
- OPT:淘汰未来最久才访问的页。
- Clock:R=1 清 0 跳过,R=0 淘汰。
- 增强 Clock:优先未引用且干净页。
十六、英文缩写速查
| 缩写 | 全称 | 中文 |
|---|---|---|
| AMAT | Average Memory Access Time | 平均内存访问时间 |
| API | Application Programming Interface | 应用程序编程接口 |
| ART | Average Response Time | 平均响应时间 |
| ASID | Address Space Identifier | 地址空间标识符 |
| ATT | Average Turnaround Time | 平均周转时间 |
| BSS | Block Started by Symbol | 未初始化数据段 |
| CFS | Completely Fair Scheduler | 完全公平调度器 |
| CLI | Clear Interrupt Flag | 清除中断标志 |
| CPU | Central Processing Unit | 中央处理器 |
| CTSS | Compatible Time-Sharing System | 兼容分时系统 |
| ELF | Executable and Linkable Format | 可执行与可链接格式 |
| FCFS | First-Come, First-Served | 先来先服务 |
| FIFO | First-In, First-Out | 先进先出 |
| FP | Frame Pointer | 栈帧指针 |
| IDT | Interrupt Descriptor Table | 中断描述符表 |
| IDTR | Interrupt Descriptor Table Register | 中断描述符表寄存器 |
| IPC | Inter-Process Communication | 进程间通信 |
| I/O | Input/Output | 输入/输出 |
| IVT | Interrupt Vector Table | 中断向量表 |
| LDE | Limited Direct Execution | 受限直接执行 |
| LFU | Least Frequently Used | 最不经常使用 |
| LRU | Least Recently Used | 最近最久未使用 |
| LWP | Light Weight Process | 轻量级进程 |
| MLFQ | Multilevel Feedback Queue | 多级反馈队列 |
| MMU | Memory Management Unit | 内存管理单元 |
| OOM | Out Of Memory | 内存耗尽 |
| OPT | Optimal Replacement | 最优替换 |
| OS | Operating System | 操作系统 |
| PA | Physical Address | 物理地址 |
| PCB | Process Control Block | 进程控制块 |
| PC | Program Counter | 程序计数器 |
| PDBR | Page Directory Base Register | 页目录基址寄存器 |
| PDE | Page Directory Entry | 页目录项 |
| PDIndex | Page Directory Index | 页目录索引 |
| PE | Portable Executable | 可移植可执行文件格式 |
| PFN | Physical Frame Number | 物理页框号 |
| PID | Process Identifier | 进程 ID |
| PIT | Programmable Interval Timer | 可编程间隔定时器 |
| PPID | Parent Process Identifier | 父进程 ID |
| PSJF | Preemptive Shortest Job First | 抢占式最短作业优先 |
| PTE | Page Table Entry | 页表项 |
| PTBR | Page Table Base Register | 页表基址寄存器 |
| PTIndex | Page Table Index | 页表索引 |
| RAM | Random Access Memory | 随机访问存储器 |
| RB Tree | Red-Black Tree | 红黑树 |
| RISC | Reduced Instruction Set Computer | 精简指令集计算机 |
| RR | Round Robin | 轮转调度 |
| SIG | Signal | 信号 |
| SJF | Shortest Job First | 最短作业优先 |
| SN | Segment Number | 段号 |
| SP | Stack Pointer | 栈指针 |
| STCF | Shortest Time-to-Completion First | 最短完成时间优先 |
| STDERR | Standard Error | 标准错误 |
| STDIN | Standard Input | 标准输入 |
| STDOUT | Standard Output | 标准输出 |
| STI | Set Interrupt Flag | 设置中断标志 |
| TLB | Translation Lookaside Buffer | 转换后备缓冲 |
| UID | User Identifier | 用户 ID |
| VA | Virtual Address | 虚拟地址 |
| VPN | Virtual Page Number | 虚拟页号 |
十七、最后复习抓手
最需要会讲清楚的主干:
- 进程为什么是 CPU 虚拟化的基本抽象:PCB 保存现场,调度器切换进程。
- 受限直接执行为什么又快又安全:用户态直接执行,系统调用/中断/异常进入内核。
- 调度算法的取舍:FCFS 简单但护航,SJF/STCF 优化周转但可能饥饿,RR 响应好但有切换开销,MLFQ 用历史行为动态预测,CFS 用 vruntime 近似公平。
- 地址空间为什么是内存虚拟化的基本抽象:进程使用虚拟地址,MMU 负责转换,OS 负责管理映射和异常。
- 分段和分页的对比:分段贴近逻辑但有外部碎片,分页固定大小便于管理但页表可能大。
- TLB 为什么必要:没有 TLB,分页访问至少多一次内存访问。
- 多级页表解决什么:节省未使用虚拟地址范围对应的页表空间,但增加查表层级。
- 交换机制如何让虚拟内存超过物理内存:Present Bit、Page Fault、换入换出、页面置换。
- 页面置换算法的本质:用历史或未来信息降低缺页率,实际系统常用近似 LRU 的 Clock。
操作系统并发复习
资料来源:并发部分 7 份课件,包括并发介绍、线程 API、锁、基于锁的并发数据结构、条件变量、信号量、常见并发问题。
十八、并发与线程基础
1. 线程是什么
线程(Thread)是进程内的一个执行流,也是 CPU 调度的基本单位。一个进程可以包含多个线程,因此有多个并发执行路径。
同一进程内线程共享:
- 代码段、全局变量、堆。
- 打开的文件描述符。
- 进程地址空间中的大部分资源。
每个线程私有:
- PC:Program Counter,程序计数器。
- 寄存器上下文。
- 栈。
- TCB:Thread Control Block,线程控制块。
TCB 用于保存线程状态,类似 PCB 之于进程。但同一进程内线程切换通常不需要切换地址空间,因此比进程切换轻量。
2. 为什么使用线程
使用线程的主要原因:
- 并行性(Parallelism):把计算任务分成多个部分,在多核 CPU 上同时运行。
- 避免阻塞:一个线程等待 I/O 时,其他线程仍可执行。
- 响应性:主线程响应用户输入,后台线程执行保存、拼写检查、网络请求等。
- 共享方便:同进程线程天然共享地址空间,比进程间通信更轻量。
代价:
- 共享数据会带来竞态条件。
- 执行顺序不确定,调试困难。
- 必须使用锁、条件变量、信号量等同步原语。
3. 线程执行顺序为什么不确定
线程执行顺序取决于:
- 操作系统调度算法。
- 线程优先级和时间片。
- 系统负载。
- I/O、锁、条件变量等阻塞事件。
- 时钟中断导致的抢占。
因此多线程程序不能依赖“某个线程一定先执行”,必须显式同步。
4. 原子性、竞态条件和临界区
原子性(Atomicity):一个操作从其他线程看来要么尚未发生,要么已经完整发生,不暴露中间状态。
counter++ 看起来是一句 C 代码,但机器层面通常至少包含:
- Load:从内存读 counter 到寄存器。
- Add:寄存器加 1。
- Store:写回内存。
这不是原子操作。两个线程交错执行时,可能都读到旧值,然后各自写回同一个新值,产生丢失更新。
竞态条件(Race Condition):程序结果依赖线程执行交错顺序,并且某些交错会导致错误。
数据竞争(Data Race):多个线程并发访问同一共享数据,至少一个是写操作,并且没有同步保护。
临界区(Critical Section):访问共享数据并可能破坏一致性的代码段。临界区需要同步原语保护,使同一时刻最多一个线程进入。
5. 同步原语概览
- 锁(Lock/Mutex):保护临界区,实现互斥。
- 条件变量(Condition Variable):等待某个条件成立。
- 信号量(Semaphore):维护整数计数,可表示资源数量、事件或二进制锁。
- 原子操作(Atomic Operation):由硬件保证不可分割,例如 CAS、Test-and-Set。
十九、Pthreads 线程 API
Pthreads 是 POSIX Threads,全称 POSIX 线程库。POSIX 是 Portable Operating System Interface,全称可移植操作系统接口。
使用 Pthreads 程序通常需要:
gcc file.c -Wall -pthread
并包含:
#include <pthread.h>
1. pthread_create()
pthread_create() 用于创建线程:
int pthread_create(pthread_t *thread,
                   const pthread_attr_t *attr,
                   void *(*start_routine)(void *),
                   void *arg);
参数:
thread:指向pthread_t的指针,用于保存新线程 ID。attr:线程属性,例如栈大小、调度策略;默认属性可传NULL。start_routine:线程入口函数。arg:传给线程入口函数的参数,类型为void *。
常见做法是把多个参数封装到结构体中,把结构体指针作为 arg 传入。
2. pthread_join()
pthread_join() 用于等待指定线程结束并回收资源:
int pthread_join(pthread_t thread, void **value_ptr);
参数:
thread:要等待的线程。value_ptr:接收线程函数返回值的地址;不关心返回值可传NULL。
易错点:
- 线程函数不能返回栈上局部变量地址。函数返回后栈帧销毁,地址会变成悬空指针。
- 如果需要返回复杂结果,应在堆上分配,主线程
pthread_join()获取后负责free()。 - 创建线程后通常要
pthread_join()或分离线程,否则资源可能不能及时回收。
3. Pthreads 互斥锁 API
Mutex 是 Mutual Exclusion,全称互斥锁。
常见接口:
pthread_mutex_t lock = PTHREAD_MUTEX_INITIALIZER;
pthread_mutex_lock(&lock);
pthread_mutex_unlock(&lock);
动态初始化:
pthread_mutex_init(&lock, NULL);
pthread_mutex_destroy(&lock);
其他接口:
pthread_mutex_trylock():锁已被占用时立即失败返回。pthread_mutex_timedlock():等待到超时时间,超时仍未获得锁则失败返回。
使用要求:
- 所有锁必须初始化。
- 加锁和解锁应检查错误码。
- 访问同一共享变量的所有代码路径必须使用同一把锁。
- 通常谁加锁谁解锁,避免所有权混乱。
4. Pthreads 条件变量 API
Condition Variable 是条件变量。
常见接口:
pthread_cond_t cond = PTHREAD_COND_INITIALIZER;
pthread_cond_wait(&cond, &mutex);
pthread_cond_signal(&cond);
pthread_cond_broadcast(&cond);
pthread_cond_wait() 的语义:
- 调用前必须已经持有 mutex。
- 调用时原子地释放 mutex,并让线程进入等待队列睡眠。
- 被唤醒后,重新获得 mutex,然后返回。
必须使用 while 重新检查条件:
pthread_mutex_lock(&mutex);
while (!condition) {
    pthread_cond_wait(&cond, &mutex);
}
pthread_mutex_unlock(&mutex);
原因:
- 可能发生虚假唤醒。
- 被唤醒后,条件可能已经被其他线程改变。
signal只表示条件可能变化,不保证条件成立。
二十、锁
1. 锁的基本思想
锁用于实现互斥,使同一时刻最多一个线程进入受保护的临界区。
锁变量通常有两种状态:
- unlocked/free:未锁定,没有线程持有。
- locked/held:已锁定,有线程持有。
lock() 获取锁;如果锁已被持有,则等待。unlock() 释放锁,并可能唤醒等待线程。
2. 评价锁的标准
互斥性(Mutual Exclusion):
- 同一时刻最多一个线程进入临界区。
公平性(Fairness):
- 等待线程是否能在有限时间内获得锁。
- 是否避免饥饿。
性能(Performance):
- 无竞争时,加锁/解锁开销是否低。
- 有竞争时,是自旋还是阻塞。
- 是否浪费 CPU 或导致大量上下文切换。
可量化为:
$$ \begin{gathered} L_i = a_i - r_i \ S_i = u_i - a_i \ \rho = \frac{C}{N} \ \omega = \frac{P}{T} \ X = \frac{K}{T} \ \varphi = \frac{\min_i G_i}{\max_i G_i} \ W_i \to \infty \end{gathered} $$
符号说明:L_i 为线程 i 的加锁等待时间;r_i 为请求锁时间;a_i 为获得锁时间;S_i 为临界区时间;u_i 为释放锁时间;\rho 为锁竞争率;C 为发生竞争的加锁次数;N 为总加锁次数;$\omega$ 为自旋浪费比例;P 为自旋消耗的 CPU 时间;T 为总 CPU 时间;X 为锁吞吐量;K 为完成的临界区次数;$\varphi$ 为公平性比值;G_i 为线程 i 成功获得锁的次数;W_i -> ∞ 表示线程 i 可能饥饿。
3. 禁用中断实现互斥
早期单处理器系统可以在临界区禁用中断:
- 禁用中断后,当前线程不会因时钟中断被抢占。
- 临界区执行完后恢复中断状态。
问题:
- 只适合内核态,用户态不能直接禁用中断。
- 只适合单处理器,多处理器上其他 CPU 仍可并发访问。
- 临界区必须很短,否则影响系统响应。
- 应保存并恢复原中断状态,而不是简单无条件启用。
4. 为什么普通变量不能实现锁
如果用普通变量 flag 实现锁:
while (flag == 1) ;
flag = 1;
检查 flag 和设置 flag 不是原子的。两个线程可能同时看到 flag == 0,然后都设置为 1 并进入临界区,互斥失败。
因此锁需要硬件原子指令。
5. Peterson 算法
Peterson 算法是双线程互斥算法。它用:
flag[i]表示线程 i 想进入临界区。turn表示双方都想进入时让谁优先。
它说明纯软件可在严格假设下实现双线程互斥。但实际系统中由于多核内存模型、编译器重排和扩展性问题,真实锁通常依赖硬件原子指令。
6. Test-and-Set 自旋锁
Test-and-Set 是测试并设置,也叫 Atomic Exchange,原子交换。
语义:
$$ \begin{gathered} old = \cdot ptr \ \cdot ptr = new \ \text{return old} \end{gathered} $$
整个操作原子执行。
自旋锁:
while (TestAndSet(&flag, 1) == 1)
    ; /* spin */
优点:
- 简单。
- 能保证互斥。
缺点:
- 忙等浪费 CPU。
- 普通自旋锁不公平,可能饥饿。
- 单核上如果持锁线程被抢占,等待线程会浪费整个时间片。
多核上,如果临界区非常短且持锁线程正在其他 CPU 上运行,自旋可能比阻塞更快。
7. CAS、LL/SC 与 FAA
CAS 是 Compare-and-Swap,全称比较并交换。
语义:
if(·ptr == expected)
	{ ·ptr = new; }
	return old value
如果返回值等于 expected,说明更新成功;否则失败,需要重试。
LL 是 Load-Linked,全称链接加载。SC 是 Store-Conditional,全称条件存储。LoadLinked(ptr) 读取值并记录地址;StoreConditional(ptr, value) 只有在此后没有其他处理器写过该地址时才成功。
FAA 是 Fetch-and-Add,全称获取并增加。它原子地返回旧值,并把内存中的值增加。
这些硬件原子指令可用于实现锁、原子计数器和无锁数据结构。
8. Ticket 锁
Ticket 锁用 FAA 实现公平自旋锁。
变量:
ticket:下一个待分配票号。turn:当前正在服务的票号。
流程:
- 线程通过 FAA 领取自己的票号
myturn。 - 自旋等待
turn == myturn。 - 释放锁时
turn++,服务下一个票号。
优点:按取票顺序进入临界区,公平。
缺点:仍然忙等,会消耗 CPU。
9. yield、park/unpark 与 futex
如果自旋过多,需要操作系统支持让线程睡眠。
yield():
- 当前线程主动放弃 CPU。
- 从 Running 变成 Ready。
- 问题是线程多时会产生大量上下文切换,也不保证公平。
park() / unpark(threadID):
park()让当前线程阻塞,不占用 CPU。unpark()唤醒指定线程,使其进入就绪队列。- 需要等待队列记录等待锁的线程。
丢失唤醒问题:
- 如果
unpark()发生在目标线程真正park()之前,唤醒可能丢失。 - 之后线程再
park(),可能永久睡眠。 - Solaris 使用
setpark()声明“即将 park”,避免丢失唤醒。
futex 是 Fast Userspace Mutex,全称快速用户态互斥。Linux futex 的思想:
- 无竞争时在用户态用原子指令完成,不进内核。
- 有竞争时才通过内核阻塞或唤醒。
常见操作:
futex_wait(address, expected):如果*address == expected,原子地加入等待队列并阻塞。futex_wake(address, n):唤醒最多 n 个等待在该地址上的线程。
10. 两阶段等待锁
两阶段等待:
- 先短暂自旋,期待锁很快释放。
- 自旋失败后阻塞睡眠,避免长期浪费 CPU。
适合多核、临界区短但竞争偶尔发生的场景。
二十一、基于锁的并发数据结构
1. 基本目标
并发数据结构的目标是让多个线程安全访问同一个数据结构,同时尽量保持性能。
需要考虑:
- 正确性:共享状态是否被同步保护,数据结构不变量是否保持。
- 死锁:是否存在错误锁顺序。
- 性能:锁粒度、锁竞争、可扩展性。
锁粒度:
- 粗粒度锁:一把锁保护整个结构。简单,但并发性差。
- 细粒度锁:多把锁保护不同部分。并发性高,但实现复杂、死锁风险更高。
2. 并发计数器
普通计数器的 increment() 是读-改-写,多个线程并发会丢失更新。
单锁计数器:
- 每次 increment/decrement/get 都先加锁。
- 正确但可扩展性差。
- 线程越多,锁竞争越严重。
注意:get() 也要加锁,因为它可能和写操作并发。
3. 近似计数器
近似计数器用多个局部计数器减少全局锁竞争。
结构:
- 一个全局计数器 G。
- 多个局部计数器 L1, L2, ...,通常每个 CPU 一个。
- 每个局部计数器一把锁,全局计数器一把锁。
- 阈值 S 控制局部值何时汇总到全局。
更新流程:
- 线程更新本 CPU 对应局部计数器。
- 如果局部计数器达到 S,获取全局锁。
- 把局部值加到全局计数器。
- 局部计数器清零。
真实总数:
$$ \begin{gathered} V = G + \sum_i L_i \ V_r = G \ \varepsilon = V - V_r = \sum_i L_i \ \varepsilon_max < nS \ \varepsilon_r = \frac{\varepsilon}{V} \end{gathered} $$
符号说明:V 为真实总数;G 为全局计数器;L_i 为第 i 个局部计数器;V_r 为读到的近似值;\varepsilon 为绝对误差;\varepsilon_max 为最大绝对误差;n 为局部计数器数量;S 为阈值;\varepsilon_r 为相对误差。
S 的权衡:
- S 小:更准确,但全局锁竞争多,性能差。
- S 大:性能好,但全局值滞后,不够精确。
4. 并发链表
粗粒度链表:
- 一把锁保护整条链表。
- 插入、查找时都持有锁。
- 正确简单,但查找和插入无法并行。
缩小临界区:
malloc()不访问链表共享状态,应放在锁外。- 只在真正修改
head和节点链接时加锁。 - 避免多个返回路径忘记
unlock()。
锁耦合:
Lock Coupling 也叫 Hand-over-Hand Locking,全称手递手加锁。
基本思想:
- 每个节点有一把锁。
- 遍历时先获取下一个节点锁。
- 再释放当前节点锁。
- 始终保证当前访问节点被锁保护。
优点:不同线程可在链表不同位置并发操作。
缺点:每经过一个节点都要加锁/解锁,开销大,实现复杂,未必比粗粒度锁快。
5. 并发队列
Michael 和 Scott 风格队列常用两把锁:
headLock:保护队头。tailLock:保护队尾。
使用 dummy node,即虚拟节点,简化空队列处理。
入队只操作尾部,因此只获取 tailLock。出队只操作头部,因此只获取 headLock。多数情况下入队和出队可以并发。
6. 并发哈希表
并发哈希表常见做法是每个桶一把锁:
- 每个桶是一条链表。
- 不同 key 落入不同桶时,可以并发插入或查找。
- 如果大量 key 落入同一桶,仍会产生锁竞争。
这种设计通过分散锁竞争提高可扩展性。
二十二、条件变量
1. 条件变量解决什么
条件变量用于解决“线程等待某个条件成立”的问题。
例子:
- 父线程等待子线程完成。
- 消费者等待缓冲区非空。
- 生产者等待缓冲区非满。
条件变量本身不保存条件。真正的条件保存在共享状态变量中,例如 done == 1、count > 0、count < MAX。
条件变量负责睡眠和唤醒;互斥锁负责保护条件对应的共享状态。
2. 自旋等待为什么不好
父线程可以不断检查 done 是否为 1:
while (done == 0)
    ;
问题:
- 一直占用 CPU。
- 等待时间越长浪费越严重。
volatile不能替代线程同步,不能保证互斥、顺序和可见性完整正确。
3. 使用条件变量实现 join
共享状态:
done:真正条件。cond:等待队列。mutex:保护done。
父线程:
pthread_mutex_lock(&mutex);
while (done == 0) {
    pthread_cond_wait(&cond, &mutex);
}
pthread_mutex_unlock(&mutex);
子线程结束:
pthread_mutex_lock(&mutex);
done = 1;
pthread_cond_signal(&cond);
pthread_mutex_unlock(&mutex);
4. 为什么必须有状态变量
错误做法:子线程只 signal(),父线程只 wait(),没有 done。
问题:
- 如果子线程先执行
signal(),此时父线程还没有wait(),信号不会保存。 - 父线程之后
wait(),可能永久睡眠。
结论:条件变量不是消息队列。必须用共享状态记录条件是否已经成立。
5. 检查条件和 wait 必须由同一把锁保护
错误窗口:
- 父线程检查
done == 0。 - 父线程准备
wait(),但还没真正睡眠。 - 子线程设置
done = 1并signal()。 - 父线程再进入
wait()。 - signal 丢失,父线程永久睡眠。
正确方式是持有同一把 mutex,并用 pthread_cond_wait() 原子释放锁并睡眠。
6. Mesa 语义与 while
Mesa 语义:signal() 只是把等待线程变为就绪状态,不会立即把 CPU 交给它。被唤醒线程真正运行前,条件可能已经被其他线程改变。
Hoare 语义:signal() 后立即把执行权交给被唤醒线程,使其在条件刚成立时运行。现代系统通常采用 Mesa 语义。
因此条件变量等待必须写成 while,不要写成 if。
7. 生产者-消费者问题
Producer-Consumer Problem 是生产者-消费者问题,也叫有界缓冲区问题。
共享资源:容量有限的缓冲区。
同步需求:
- 互斥:生产者和消费者不能同时破坏缓冲区结构、计数和索引。
- 条件同步:缓冲区满时生产者等待;缓冲区空时消费者等待。
单槽缓冲区中:
count == 0:空,可以 put,不能 get。count == 1:满,可以 get,不能 put。
8. 为什么需要两个条件变量
只用一个条件变量时,signal() 可能唤醒错误类型线程。
例:消费者取走数据后,应该唤醒生产者;但单一条件变量可能唤醒另一个消费者。被唤醒消费者发现仍然为空,再次睡眠,系统可能没有线程推进。
正确方案:
empty:表示缓冲区非满,生产者等待它。fill:表示缓冲区非空,消费者等待它。- 等待时使用
while。
生产者:
pthread_mutex_lock(&mutex);
while (count == MAX)
    pthread_cond_wait(&empty, &mutex);
put(item);
pthread_cond_signal(&fill);
pthread_mutex_unlock(&mutex);
消费者:
pthread_mutex_lock(&mutex);
while (count == 0)
    pthread_cond_wait(&fill, &mutex);
item = get();
pthread_cond_signal(&empty);
pthread_mutex_unlock(&mutex);
9. 覆盖条件与 broadcast
覆盖条件(Covering Condition):多个线程等待在同一个条件变量上,但每个线程真正需要的条件不同。
例:内存分配中,一个线程等 100 字节,一个线程等 10 字节。释放 50 字节后,应唤醒等待 10 字节的线程,但 signal() 不一定选中它。
解决方法:
- 使用
pthread_cond_broadcast()唤醒所有等待线程。 - 每个线程醒来后重新检查自己的条件。
- 条件不满足的线程再次睡眠。
代价是可能唤醒过多线程。
二十三、信号量
1. 信号量定义
Semaphore 是信号量。它是一个同步对象,维护一个整数计数值。
POSIX 信号量常见操作:
sem_init():初始化。sem_wait():申请资源,P 操作。sem_post():释放资源或发送事件,V 操作。
P 操作来自荷兰语 proberen,表示尝试。V 操作来自荷兰语 verhogen,表示增加。
2. sem_wait()
语义:
- 如果信号量值大于 0,立即减 1 并返回。
- 如果信号量值等于 0,调用线程阻塞,直到其他线程执行
sem_post()。
它常用于申请资源。
3. sem_post()
语义:
- 原子地增加信号量值。
- 如果有线程阻塞在该信号量上,唤醒其中一个。
- 被唤醒线程只是变为就绪,不一定立刻运行。
它常用于释放资源或通知事件发生。
4. 二进制信号量实现互斥
初始值为 1 的信号量可以作为二进制锁:
- 1:资源可用,线程可进入临界区。
- 0:资源被占用,其他线程等待。
用法:
sem_wait(&mutex);
/* critical section */
sem_post(&mutex);
5. 信号量实现事件等待
父线程等待子线程结束时,信号量初始值应为 0:
- 初始 0 表示事件未发生。
- 父线程
sem_wait()等待。 - 子线程完成后
sem_post()。
如果初始值设为 1,父线程不会等待,会直接继续执行,这是错误的。
信号量与条件变量的区别之一:信号量计数可以保存事件。如果子线程先 sem_post(),父线程之后 sem_wait() 可以直接通过。
6. 信号量解决生产者-消费者
使用三个信号量:
empty:空槽数量,初始为 MAX。full:已填充槽数量,初始为 0。mutex:二进制信号量,保护缓冲区、fill、use、count。
生产者:
sem_wait(&empty);
sem_wait(&mutex);
put(item);
sem_post(&mutex);
sem_post(&full);
消费者:
sem_wait(&full);
sem_wait(&mutex);
item = get();
sem_post(&mutex);
sem_post(&empty);
关键规则:先等资源条件,再进互斥区;不要在持有 mutex 时等待 empty/full。
7. 读写锁
Reader-Writer Lock 是读写锁。
需求:
- 读操作不修改数据,多个读者可以并发。
- 写操作修改数据,写者必须独占。
- 写者运行时不能有读者或其他写者。
读者优先实现思想:
- 第一个读者获取
writelock,阻止写者。 - 后续读者只增加读者计数,可以并发读。
- 最后一个读者释放
writelock。
问题:如果读者持续到来,写者可能长期等待,产生写者饥饿。
8. 哲学家就餐问题
Dining Philosophers Problem 是哲学家就餐问题。
场景:
- 5 个哲学家围坐。
- 每两人之间一把叉子,共 5 把。
- 哲学家吃饭需要同时拿到左右两把叉子。
目标:
- 无死锁。
- 无饥饿。
- 尽量高并发。
错误方案:所有哲学家都先拿左叉,再拿右叉。若所有人同时拿到左叉并等待右叉,会形成循环等待,死锁。
解决思路:
- 打破循环等待:让一个哲学家先拿右叉再拿左叉,或规定全局资源顺序。
- 限制并发数:最多允许 4 个哲学家同时尝试拿叉子。
- 用条件变量记录哲学家状态。
9. 线程节流
线程节流用于限制同时执行某段高开销代码的线程数量。
做法:使用计数信号量,初始值为允许并发数 N。
sem_wait(&limit);
/* expensive operation */
sem_post(&limit);
10. 用锁和条件变量实现信号量
简化信号量可以用:
- 一个整数
value。 - 一个互斥锁保护
value。 - 一个条件变量让等待线程睡眠。
wait:
pthread_mutex_lock(&lock);
while (value == 0)
    pthread_cond_wait(&cond, &lock);
value--;
pthread_mutex_unlock(&lock);
post:
pthread_mutex_lock(&lock);
value++;
pthread_cond_signal(&cond);
pthread_mutex_unlock(&lock);
while 仍然必要,用于防止虚假唤醒或条件被其他线程抢先改变。
二十四、常见并发错误
1. 非死锁错误
非死锁并发错误不会让程序永久停住,但可能导致程序崩溃、数据不一致或结果错误。
两类主要非死锁错误:
- 原子性违反。
- 顺序违反。
真实系统中,非死锁错误数量往往多于死锁错误。
2. 原子性违反
Atomicity Violation 是原子性违反。
定义:本应连续、不可被打断执行的操作序列,被其他线程插入,导致错误。
典型“检查后使用”竞态:
- 线程 1 检查
ptr != NULL。 - 线程 1 尚未使用 ptr。
- 线程 2 把 ptr 设为
NULL。 - 线程 1 继续使用 ptr。
- 可能空指针访问或崩溃。
修复方法:
- 用同一把锁保护所有访问。
- 检查和使用必须放在同一个临界区。
- 修改该共享变量的线程也必须持有同一把锁。
3. 顺序违反
Ordering Violation 是顺序违反。
定义:程序逻辑要求 A 在 B 之前发生,但并发执行没有强制这个顺序。
例:
- 线程 A 初始化对象。
- 线程 B 使用对象。
- 如果没有同步,B 可能在 A 初始化完成前使用对象。
修复方法:
- 使用条件变量、信号量或 join 强制顺序。
- 用状态变量记录“初始化完成”。
- 用互斥锁保护状态变量。
4. 死锁
Deadlock 是死锁。一组线程互相等待对方持有的资源,导致所有线程都无法继续。
典型例子:
- 线程 1 持有 L1,等待 L2。
- 线程 2 持有 L2,等待 L1。
大型系统容易死锁的原因:
- 模块依赖复杂。
- 不同模块有自己的锁。
- 封装隐藏了函数内部会获取哪些锁。
- 调用者可能无意中形成嵌套锁和循环等待。
5. 死锁四个必要条件
死锁发生必须同时满足:
- 互斥(Mutual Exclusion):资源一次只能被一个线程持有。
- 持有并等待(Hold and Wait):线程持有至少一个资源,同时等待其他资源。
- 不可抢占(No Preemption):已获得资源不能被系统强制抢走,只能主动释放。
- 循环等待(Circular Wait):存在线程等待环。
破坏任意一个条件,就能防止死锁。
6. 死锁预防
破坏循环等待:
- 为所有锁规定全局顺序。
- 所有线程按相同顺序获取锁。
- 大系统中可使用偏序,而非完整全序。
破坏持有并等待:
- 一次性获取所需全部锁。
- 可用一把全局
prevention锁保护“获取多把锁”的过程。 - 缺点是并发性下降,且必须提前知道需要哪些锁。
破坏不可抢占:
- 使用
trylock()。 - 如果拿不到后续锁,就释放已经持有的锁,稍后重试。
减少互斥:
- 使用 CAS、FAA、LL/SC 等原子操作构造无锁数据结构。
- 无显式锁则不会发生锁导致的死锁。
7. 活锁
Livelock 是活锁。线程没有阻塞,也一直在执行,但不断重复失败尝试,系统没有实际进展。
例:两个线程都用 trylock(),拿不到第二把锁就释放第一把并立刻重试。如果它们总是同步重试,可能一直冲突。
缓解方法:
- 随机延迟。
- 退避策略。
- 打破同步重试模式。
死锁和活锁区别:
- 死锁:线程阻塞,无法继续。
- 活锁:线程运行,但没有有效进展。
8. 无锁原子加法
CAS 实现原子加法:
do {
    old = value;
    new = old + amount;
} while (CAS(&value, old, new) != old);
优点:
- 不需要显式锁。
- 不会发生锁死锁。
缺点:
- 高竞争下可能反复失败,性能下降。
- 可能出现类似活锁的持续重试。
9. 死锁避免与银行家算法
Deadlock Avoidance 是死锁避免。它不一定破坏必要条件,而是在运行时根据系统状态做决策,避免进入可能死锁的不安全状态。
Banker's Algorithm 是银行家算法。它通过谨慎分配资源,确保系统始终处于安全状态。
安全状态(Safe State):存在至少一个线程执行序列,使所有线程最终都能获得最大需求资源并顺利结束。
需要维护:
- E:Existing Resource,系统中每类资源总数。
- A:Available Resource,当前可用资源数量。
- M:Maximum Claim,每个线程对每类资源的最大需求。
- C:Current Allocation,每个线程当前已分配资源。
- N:还可能需要的资源,
N = M - C。 - R:Request,当前请求。
矩阵表达:
$$ \begin{gathered} N_{ij} = M_{ij} - C_{ij} \ R_{ij} \le A_j \ R_{ij} \le N_{ij} \ \exists(p_1,...,p_n), \forall k: N_{p_k} \le W_k \ W_{k+1} = W_k + C_{p_k} \end{gathered} $$
符号说明:E_j 为第 j 类资源总量;A_j 为第 j 类当前可用资源量;M_{ij} 为线程 i 对资源 j 的最大需求;C_{ij} 为线程 i 已持有的资源 j 数量;N_{ij} 为线程 i 对资源 j 的剩余需求;R_{ij} 为线程 i 当前请求资源 j 的数量;p_k 为安全序列中的第 k 个线程;W_k 为检查到第 k 步时的可用资源向量。
判断当前状态是否安全:
- 找一个尚未完成且
Need <= A的线程。 - 假设它完成,释放其资源:
A' = A + C_i。 - 标记该线程完成。
- 重复直到所有线程完成,或找不到可完成线程。
- 若所有线程可完成,则状态安全,并得到安全序列。
判断请求能否批准:
- 检查
Request <= Need。 - 检查
Request <= A。 - 假设批准:更新
A' = A - R_i,C_i' = C_i + R_i,N_i' = N_i - R_i。 - 运行安全性检查。
- 若假设后仍安全,则批准;否则不批准。
银行家算法局限:
- 线程和资源数量需要相对固定。
- 每个线程必须提前声明最大需求。
- 请求模式需要可预测。
- 实际程序动态创建线程、动态申请资源,很难满足假设。
10. 死锁检测与恢复
Deadlock Detection and Recovery 是死锁检测与恢复。
思路:
- 允许死锁偶尔发生。
- 定期构建资源分配图或等待图。
- 如果图中存在环,说明可能死锁。
- 选择一个或多个线程/事务中止,释放资源。
数据库系统常使用这种方式:周期性检测事务等待图中的环,发现死锁后中止某个事务。
二十五、并发常考模板
1. 判断是否需要加锁
如果满足以下条件,就需要同步:
- 多个线程访问同一共享数据。
- 至少一个线程写。
- 没有其他机制保证互斥、原子性或顺序。
答题关键词:共享变量、读-改-写、临界区、数据竞争、丢失更新。
2. 正确使用条件变量
模板:
pthread_mutex_lock(&mutex);
while (!condition) {
    pthread_cond_wait(&cond, &mutex);
}
/* use condition */
pthread_mutex_unlock(&mutex);
说明必须写:
- 条件变量本身不保存条件。
- 条件由共享状态变量表示。
wait前必须持有锁。wait会原子释放锁并睡眠。- 醒来后必须用
while重新检查条件。
3. 生产者-消费者条件变量模板
生产者:
pthread_mutex_lock(&mutex);
while (count == MAX)
    pthread_cond_wait(&empty, &mutex);
put(item);
pthread_cond_signal(&fill);
pthread_mutex_unlock(&mutex);
消费者:
pthread_mutex_lock(&mutex);
while (count == 0)
    pthread_cond_wait(&fill, &mutex);
item = get();
pthread_cond_signal(&empty);
pthread_mutex_unlock(&mutex);
4. 生产者-消费者信号量模板
生产者:
sem_wait(&empty);
sem_wait(&mutex);
put(item);
sem_post(&mutex);
sem_post(&full);
消费者:
sem_wait(&full);
sem_wait(&mutex);
item = get();
sem_post(&mutex);
sem_post(&empty);
关键解释:先等资源条件,再进互斥区;不要持有 mutex 去等 empty/full。
5. 判断死锁
检查四个必要条件:
- 是否互斥。
- 是否持有并等待。
- 是否不可抢占。
- 是否循环等待。
若题目问如何预防,回答破坏其中一个条件:
- 规定全局锁顺序,破坏循环等待。
- 一次性申请所有锁,破坏持有并等待。
- 用
trylock()失败后释放已持有锁,破坏不可抢占。 - 用无锁原子操作减少互斥。
6. 银行家算法模板
计算:
$$ N = M - C $$
安全性检查:
$$ \begin{gathered} W_0 = A \ \exists i: done_i = 0 \land N_i \le W_k \ W_{k+1} = W_k + C_i \ done_i = 1 \ \forall i: done_i = 1 \Rightarrow \text{safe} \ \exists i: done_i = 0 \Rightarrow \text{unsafe} \end{gathered} $$
符号说明:N 为剩余需求矩阵;M 为最大需求矩阵;C 为已分配矩阵;W_k 为第 k 步可用资源向量;A 为初始可用资源向量;done_i 表示线程 i 是否可完成。
资源请求判断:
$$ \begin{gathered} \text{if } Request > Need: \text{error} \ \text{if } Request > Available: \text{wait} \ \text{假设分配后运行安全性检查} \ \text{安全则批准,不安全则拒绝} \end{gathered} $$
二十六、并发英文缩写速查
| 缩写 | 全称 | 中文 |
|---|---|---|
| CAS | Compare-and-Swap | 比较并交换 |
| FAA | Fetch-and-Add | 获取并增加 |
| LL | Load-Linked | 链接加载 |
| POSIX | Portable Operating System Interface | 可移植操作系统接口 |
| Pthreads | POSIX Threads | POSIX 线程库 |
| SC | Store-Conditional | 条件存储 |
| TCB | Thread Control Block | 线程控制块 |
二十七、并发最后复习抓手
- 线程和进程的区别:线程共享地址空间,但有私有 PC、寄存器、栈和 TCB。
- 并发错误根源:共享数据 + 至少一个写 + 缺少同步。
counter++不是原子操作,典型导致丢失更新。- 锁保护临界区,正确性要靠所有访问路径都使用同一把锁。
- 自旋锁依赖硬件原子指令;短临界区多核可用,长等待会浪费 CPU。
- futex 的核心是无竞争用户态完成,有竞争才进内核睡眠。
- 条件变量必须和 mutex、状态变量、while 一起使用。
- 生产者-消费者问题要同时解决互斥和条件同步。
- 信号量既能做二进制锁,也能做计数资源和事件通知。
- 死锁四条件必须同时满足;破坏任一条件即可预防。
- 银行家算法的核心是“假设分配后仍有安全序列才批准”。
操作系统持久化复习
资料来源:持久化部分 4 份课件,包括 I/O 设备、磁盘驱动器、文件和目录、文件系统实现。
二十八、I/O 设备
1. I/O 设备与操作系统职责
I/O 是 Input/Output,全称输入/输出。I/O 设备让计算机与外部环境交换数据。
常见设备:
- 输入设备:键盘、鼠标、摄像头。
- 输出设备:显示器、打印机、扬声器。
- 双向通信设备:网卡、蓝牙控制器。
- 持久化存储设备:HDD、SSD、U 盘。
操作系统管理 I/O 设备时要解决:
- 如何向设备发命令。
- 如何传输数据。
- 如何知道设备完成操作。
- 如何隐藏不同设备的硬件差异。
- 如何让应用程序使用统一接口访问设备。
2. I/O 系统为什么分层
现代计算机通常采用层次化 I/O 互联结构。
原因:
- 设备带宽不同。
- 访问延迟不同。
- 设备数量不同。
- 成本不同。
- 可扩展性要求不同。
- 有些设备需要热插拔。
一般规律:
- 高带宽、低延迟设备更靠近 CPU,例如 GPU、部分 NVMe SSD。
- 低速、数量多或可插拔设备通过芯片组和外设总线连接,例如 USB、SATA 设备。
DMI 是 Direct Media Interface,全称直接媒体接口,是 Intel 平台中 CPU 和芯片组之间的高速连接通道。
PCIe 是 Peripheral Component Interconnect Express,全称高速串行计算机扩展总线标准。
USB 是 Universal Serial Bus,全称通用串行总线。
SATA 是 Serial Advanced Technology Attachment,全称串行高级技术附件。
NVMe 是 Non-Volatile Memory Express,全称非易失性内存主机控制器接口规范。
3. 标准设备接口
操作系统通常通过设备控制器暴露的寄存器控制设备:
- 状态寄存器(Status Register):表示设备是否忙、是否完成、是否出错。
- 命令寄存器(Command Register):告诉设备执行什么操作。
- 数据寄存器(Data Register):传输少量数据或参数。
设备控制器负责把这些寄存器操作转换成真实硬件动作。
4. 轮询式 PIO
PIO 是 Programmed I/O,全称程序控制 I/O。轮询式 PIO 中,CPU 通过设备寄存器搬运数据,并不断检查状态寄存器。
典型流程:
- CPU 读取状态寄存器,等待设备空闲。
- CPU 把数据写入数据寄存器。
- CPU 把命令写入命令寄存器。
- 设备开始工作。
- CPU 不断轮询状态寄存器,直到操作完成。
优点:
- 实现简单。
- 对非常快或非常简单的设备可能足够。
缺点:
- 忙等待,浪费 CPU。
- 慢速设备会拖累系统并发能力。
5. 中断驱动 I/O
中断驱动 I/O 让设备在完成操作或发生异常时主动通知 CPU。
流程:
- 进程发起 I/O 请求。
- 设备开始执行。
- 如果进程必须等待结果,OS 阻塞该进程。
- 调度器运行其他可执行线程或进程。
- 设备完成后触发硬件中断。
- CPU 进入内核中断处理程序。
- 内核记录完成状态并唤醒等待进程。
优点:
- 允许计算与 I/O 重叠。
- CPU 不必一直忙等。
缺点:
- 中断本身有处理开销。
- 高频小 I/O 如果每次都中断,可能产生大量中断开销。
6. DMA
DMA 是 Direct Memory Access,全称直接内存访问。
DMA 的目标是不让 CPU 逐字节或逐块搬运大量数据。CPU 只负责设置传输参数,设备控制器或 DMA 控制器负责在设备和内存之间搬运数据。
基本流程:
- OS 通过设备驱动配置 DMA 描述符,包括内存地址、数据长度、传输方向。
- CPU 启动 I/O。
- 当前进程阻塞,CPU 可运行其他进程。
- DMA 控制器与设备控制器完成数据传输。
- 传输完成后,设备或 DMA 控制器通过中断通知 CPU。
DMA 的优势:
- 减少 CPU 数据搬运负担。
- 提高大块 I/O 吞吐。
- 让 CPU 与 I/O 更好重叠。
7. 端口映射 I/O 与 MMIO
端口映射 I/O:
- 使用独立的 I/O 地址空间。
- CPU 用专门 I/O 指令访问设备寄存器。
- x86 典型指令是
in和out。
MMIO 是 Memory-Mapped I/O,全称内存映射 I/O。
MMIO 的做法:
- 把设备寄存器映射到处理器物理地址空间中的一段地址。
- CPU 用普通 load/store 指令访问这些地址。
- 硬件地址译码逻辑把访问路由到设备而不是 DRAM。
- OS 通常把设备 MMIO 物理地址映射到内核虚拟地址空间,供驱动使用。
DRAM 是 Dynamic Random Access Memory,全称动态随机访问存储器。
8. 设备驱动
设备驱动程序封装硬件差异,向上提供统一接口。
典型分层:
$$ \text{应用程序}\rightarrow\text{POSIX API}\rightarrow\text{文件系统}\rightarrow\text{通用块设备层}\rightarrow\text{设备驱动}\rightarrow\text{设备控制器} $$
驱动通常运行在内核态,直接操作硬件,涉及中断、DMA、并发和设备差异,因此是内核错误的重要来源之一。
二十九、磁盘驱动器
1. LBA 与扇区
机械硬盘向 OS 提供线性的逻辑块地址空间。
LBA 是 Logical Block Address,全称逻辑块地址。操作系统通过 LBA 对磁盘执行读写,不需要知道扇区在盘片上的物理位置。
Sector 是扇区。传统磁盘常使用 512 B 扇区,现代设备也可能使用 4 KB 扇区。
2. HDD 结构
HDD 是 Hard Disk Drive,全称机械硬盘。
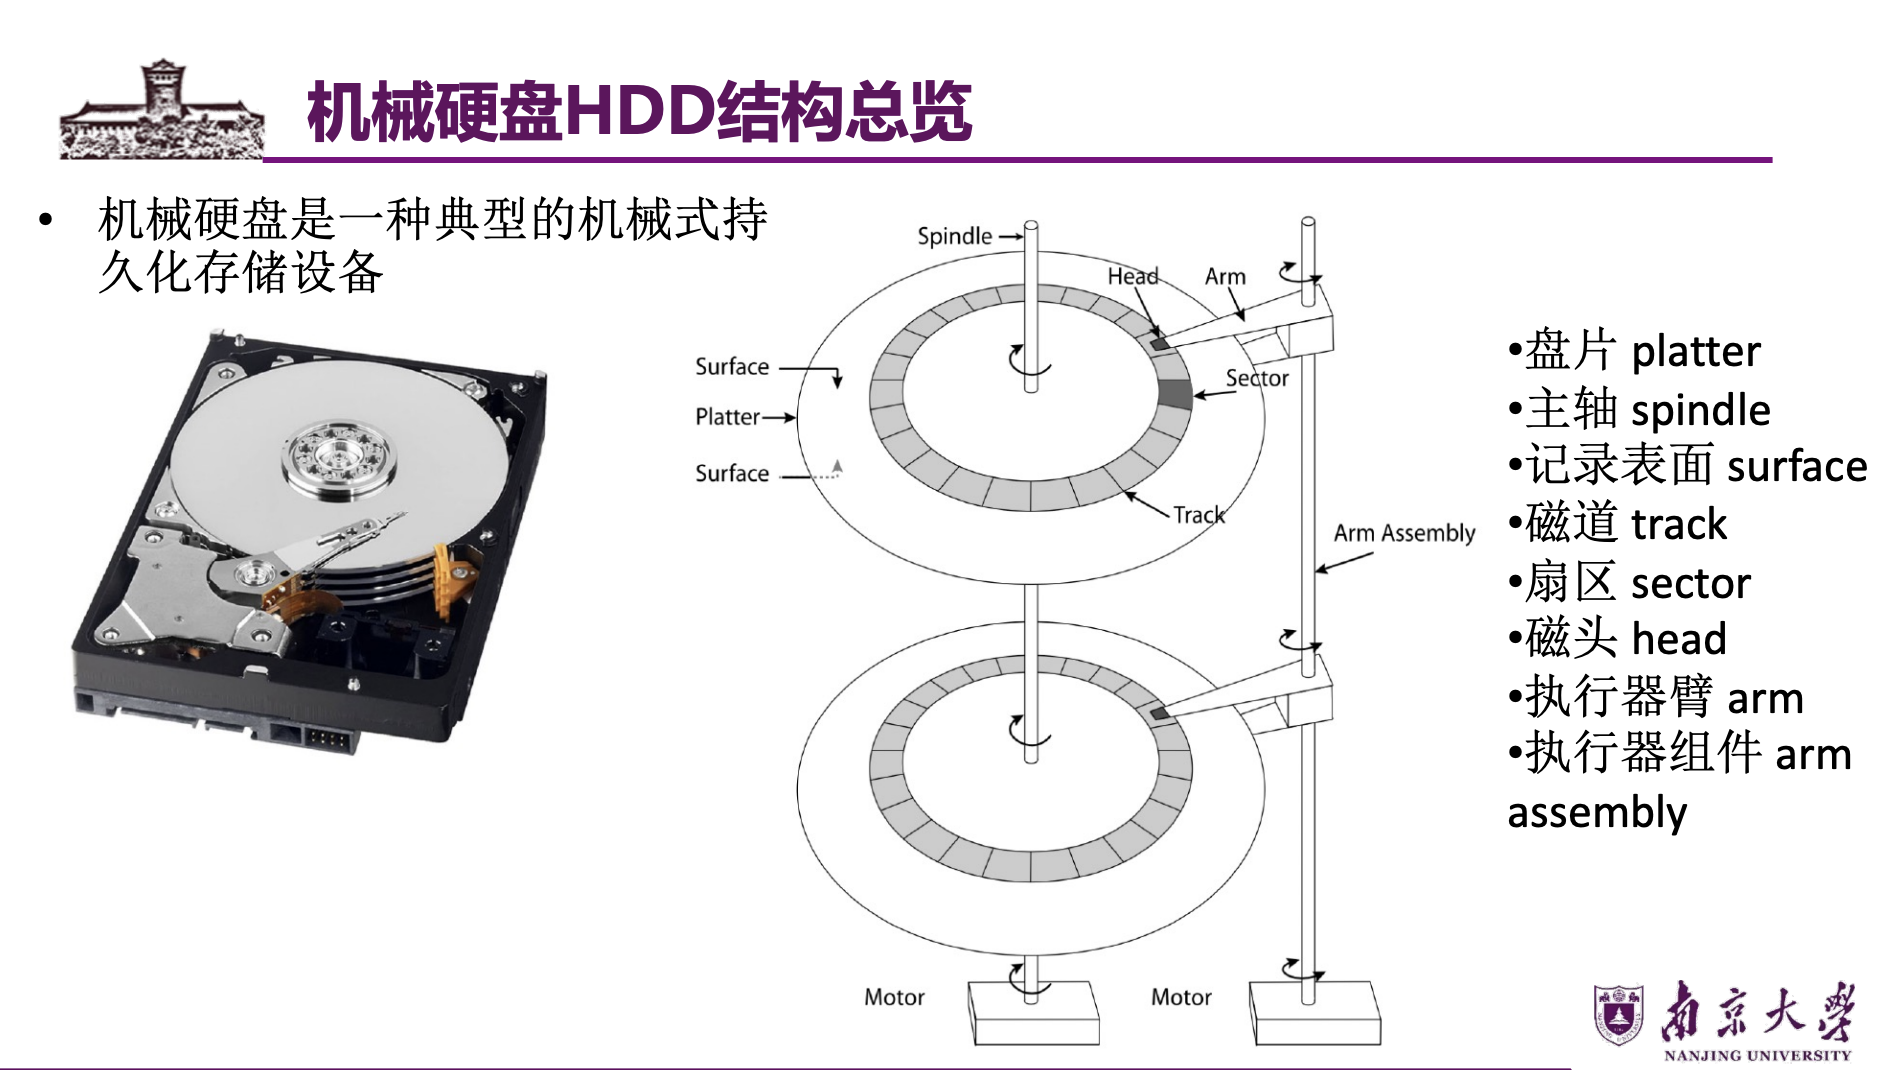 主要组件:
- Platter:盘片。
- Surface:记录表面。
- Spindle:主轴。
- Track:磁道,盘片表面上的同心圆。
- Cylinder:柱面,多个记录表面上半径相同的磁道集合。
- Sector:扇区,磁道上的编号数据单元。
- Head:磁头。
- Arm / Actuator Assembly:执行器臂/执行器组件,控制磁头径向移动。
盘片断电后仍可保存数据,因此 HDD 是持久化存储设备。
3. RPM 与旋转延迟
RPM 是 Rotations Per Minute,全称每分钟转数。
旋转一圈时间:
$$ T_{rot}=\frac{60}{RPM} $$
平均旋转延迟约为半圈时间:
$$ R_{avg}=\frac{T_{rot}}{2} $$
例:10000 RPM 磁盘:
$$ \begin{gathered} T_{rot} = 60 / 10000 = 0.006\text{s} = 6\text{ms} \ R_{avg} = 3\text{ms} \end{gathered} $$
4. HDD 访问时间
一次机械硬盘 I/O 主要由三部分组成:
$$ T_{IO} = S + R + X $$
符号说明:T_{rot} 为旋转一圈时间;RPM 为每分钟转数;R_{avg} 为平均旋转延迟;T_{IO} 为一次 I/O 时间;S 为寻道时间;R 为旋转延迟;X 为传输时间。
- Seek Time:寻道时间,磁头移动到目标磁道的时间。
- Rotational Delay:旋转延迟,等待目标扇区转到磁头下方的时间。
- Transfer Time:传输时间,真正读写数据的时间。
顺序访问:
- 初始寻道和旋转开销可被大量连续数据摊薄。
- 性能主要受传输速率限制。
随机小块访问:
- 每次都可能有寻道和旋转延迟。
- 性能主要受机械定位时间限制。
- 吞吐量远低于顺序访问。
5. 随机吞吐量估算
公式:
$$ \begin{gathered} T = S + R + X \ B = \frac{Q}{T} \end{gathered} $$
符号说明:T 为一次 I/O 总时间;S 为寻道时间;R 为旋转延迟;X 为传输时间;B 为吞吐量;Q 为请求大小。
例:随机读取 16 KB,若总耗时约 6.1 ms:
$$ B = 16\text{KB} / 6.1\text{ms} \approx 2.6\text{MB}/s $$
课件结论:即使高转速 HDD,小块随机访问吞吐也会大幅下降。文件系统应尽量提高局部性,减少随机寻道。
6. 磁盘调度算法
FCFS 是 First-Come, First-Served,全称先到先服务。
- 按请求到达顺序处理。
- 简单公平。
- 磁头移动可能很大,性能差。
SSTF 是 Shortest-Seek-Time-First,全称最短寻道时间优先。
- 选择距离当前磁头最近的请求。
- 能减少寻道距离。
- 可能导致远处请求饥饿。
SCAN 是电梯算法。
- 磁头像电梯一样沿一个方向移动,处理沿途请求。
- 到边界后反向。
- 比 FCFS/SSTF 更均衡。
CSCAN:
- 它只在一个方向上处理请求。比如规定只向右处理: 向右移动,沿途处理请求;到达最大磁道后,直接回到最小磁道;然后继续向右处理。
LOOK 是 SCAN 的改进。
- 不一定走到磁盘边界。
- 当前方向上没有更多请求时就反向。
SPTF 是 Shortest Positioning Time First,全称最短定位时间优先。
- 同时考虑寻道时间和旋转延迟。
- 选择预计定位时间最短的请求。
调度指标和选择函数:
$$ \begin{gathered} d_i = |x_i - x_0| \ D = \sum d_i \ k_{SSTF} = \arg\min_i d_i \ p_i = s_i + r_i \ k_{SPTF} = \arg\min_i p_i \ L_{avg} = (1/n) \sum (c_i - a_i) \ B = \frac{Q}{T} \end{gathered} $$
符号说明:d_i 为请求 i 与当前磁头位置的柱面距离;x_i 为请求 i 的磁道或柱面号;x_0 为当前磁头位置;D 为总磁头移动距离;k_{SSTF} 为 SSTF 选择的请求;p_i 为请求 i 的定位时间;s_i 为寻道时间;r_i 为旋转延迟;k_{SPTF} 为 SPTF 选择的请求;L_{avg} 为平均请求延迟;c_i 为完成时间;a_i 为到达时间;B 为磁盘吞吐量;Q 为传输字节数;T 为总耗时。
7. 现代 HDD 的分层调度和缓存
现代系统中,调度可能发生在多层:
- OS 块层合并和排序请求。
- 设备驱动提交命令。
- 硬盘控制器或固件对已排队命令重新排序。
NCQ 是 Native Command Queuing,全称原生命令队列。SATA NCQ 允许设备同时接收多个请求并由设备内部重排。
设备缓存:
- 读取缓存:缓存已读数据。
- 预读:固件可能读取相邻扇区。
- 写入缓存:数据进入设备缓存后,设备可能先向系统报告完成,之后再写入持久介质。
写缓存提高性能,但如果断电前未真正落盘,可能影响持久性。
三十、文件和目录
1. 文件抽象
文件是操作系统为持久存储信息提供的核心抽象。
可以把文件看成持久保存的字节数组,支持:
- read:读。
- write:写。
- seek/lseek:定位。
- truncate:截断。
文件数据是字节序列;文本文件只是字节序列的一种解释方式。
文件元数据包括:
- 文件大小。
- 所有者和组。
- 访问权限。
- 时间戳:atime、mtime、ctime。
- 数据块位置或索引结构。
atime 是 Access Time,全称最近访问时间。
mtime 是 Modification Time,全称最近内容修改时间。
ctime 是 Change Time,全称 inode 状态改变时间。
birth time 表示创建时间,部分文件系统支持。
2. 文件系统职责
文件系统负责组织、存储、检索文件数据和元数据。
主要职责:
- 提供文件和目录抽象。
- 提供统一系统调用接口,例如
open、read、write、close。 - 将文件名映射到底层存储对象,例如 inode。
- 管理磁盘空间,分配和释放数据块。
- 维护元数据:大小、权限、时间、数据块索引。
- 保证一致性和可靠性。
- 向底层块设备发读写请求。
三个视角:
- 用户视角:文件和目录。
- OS 视角:inode、目录项、打开文件表。
- 设备视角:块读写接口。
3. 文件的三种标识
inode 编号:
- 文件系统内部对象编号。
- 用于定位文件元数据。
路径名(Pathname):
- 面向用户的字符串名称。
- 通过目录逐级解析为 inode。
文件描述符 FD:
- FD 是 File Descriptor,全称文件描述符。
- 进程打开文件后获得的整数句柄。
- 后续
read、write、lseek、close使用 FD。 - FD 是进程私有的,不是磁盘上的永久名称。
4. inode
inode 是 Unix 类文件系统中表示文件对象的核心数据结构。
一个 inode 对应一个文件对象,记录元数据和数据块索引。inode 通常不记录文件名。
inode 中常见信息:
- 文件类型:普通文件、目录、符号链接等。
- 文件大小。
- UID:User Identifier,用户 ID。
- GID:Group Identifier,组 ID。
- 访问权限。
- 时间戳。
- link count:链接计数。
- 数据块索引:直接块、间接块、extent 或其他结构。
inode 编号在同一文件系统内唯一。不同文件系统可有相同 inode 编号。文件删除后,inode 编号可能被回收再分配。
定位 inode 的基本计算:
$$ \begin{gathered} o_i = i \cdot S_i \ A_i = A_0 + o_i \end{gathered} $$
符号说明:$o_i$ 为 inode i 相对 inode 表起点的偏移;i 为 inode 编号;$S_i$ 为 inode 大小;$A_i$ 为 inode i 的地址;$A_0$ 为 inode 表起始地址。
注意实际系统可能从 1 编号,课件示例从 0 编号,做题要看题目说明。
5. 路径与目录
目录是一种特殊文件,其内容是一组目录项。
目录项通常保存:
$$ \langle\text{file name},\text{inode number}\rangle $$
路径解析就是从根目录或当前目录开始,逐级查找目录项,最终找到目标 inode。
绝对路径从根目录 / 开始,例如 /usr/bin/gcc。
相对路径从当前工作目录开始,例如 ./src/main.c。
目录通常包含:
.:当前目录。..:父目录。
根目录是文件系统命名空间起点。在 ext 类文件系统中根目录常为 inode 2,但不是所有文件系统都通用。
6. 文件描述符、打开文件表与 inode
文件打开后通常涉及三层结构:
- 进程 FD 表。
- 系统级 open file description 表。
- inode 表。
进程 FD 表:
- 每个进程私有。
- FD 是表项索引。
- 表项指向系统级 open file description。
系统级 open file description:
- 每次
open()通常创建一个新的 open file description。 - 记录当前文件偏移量 offset。
- 记录 status flags,例如
O_RDONLY、O_APPEND。 - 指向 inode/vnode。
inode 表:
- 表示磁盘文件对象。
- 保存元数据和数据块索引。
重点:offset 位于系统级 open file description 中。
7. 分别 open、fork、dup 的区别
分别 open() 同一文件:
- 通常产生不同的 open file description。
- 指向同一个 inode。
- offset 各自独立。
fork() 后:
- 子进程继承父进程 FD 表。
- 父子进程对应 FD 指向同一个 open file description。
- offset 共享。
dup() / dup2():
- 在同一进程内复制文件描述符。
- 新 FD 和旧 FD 指向同一个 open file description。
- offset 共享。
这是文件描述符题的核心。
8. 常见文件系统接口
open():打开或创建指定路径文件,返回 FD。read():从 FD 读取数据,并推进 offset。write():向 FD 写入数据,并推进 offset。close():关闭 FD,减少 open file description 引用计数。lseek():修改 open file description 中的 offset。fsync():请求将文件数据和必要元数据刷新到持久存储。
9. 目录操作
操作系统通常不允许用户直接写目录文件。目录修改必须通过系统调用完成:
mkdir():创建目录。rmdir():删除空目录。opendir():打开目录流。readdir():读取下一个目录项。link():创建硬链接,新增目录项指向已有 inode。unlink():删除目录项,减少 inode 链接计数。rename():重命名或移动目录项。
10. 硬链接
Hard Link 是硬链接。
硬链接是在目录中新增一个文件名,使它指向已有文件的 inode。
创建:
ln a.txt b.txt
特点:
- 多个文件名指向同一个 inode。
- inode 的 link count 增加。
unlink()删除的是目录项,不是立即删除文件数据。- 当 link count 变为 0 且没有打开文件引用时,文件数据才真正释放。
限制:
- 通常不能跨文件系统,因为 inode 编号只在单个文件系统内有意义。
- 普通用户通常不能硬链接目录,避免目录树形成环和
..语义混乱。
11. 符号链接
Symbolic Link 是符号链接,也叫软链接。
创建:
ln -s a.txt b.txt
特点:
- 符号链接是特殊文件。
- 文件内容保存目标路径名。
- 不直接指向目标 inode。
- 可以跨文件系统。
- 可以指向目录。
- 可以指向不存在的路径。
- 删除符号链接本身不影响目标文件。
- 删除目标文件会使符号链接变成 dangling link,即悬空链接。
访问符号链接时,系统读取其中保存的目标路径,再继续路径解析。符号链接可能形成循环,系统通常设置解析次数上限,超过后返回 ELOOP。
12. 文件保护与挂载
Unix 文件系统使用 UID、GID 和权限位控制访问。
权限对象:
- user:文件所有者。
- group:所属组。
- others:其他用户。
权限类型:
- 普通文件:read、write、execute。
- 目录:list、create/delete/rename、traverse/search。
Mount 是挂载。mount() 把一个文件系统挂载到目录树中的挂载点,形成统一目录树,并支持不同文件系统共存。
VFS 是 Virtual File System,全称虚拟文件系统。VFS 向上提供统一接口,向下适配不同文件系统。
如果某进程正在使用挂载点中的文件,卸载可能失败,提示 device busy。
三十一、文件系统实现
1. 文件系统两个核心问题
文件系统实现要回答:
- 数据结构:磁盘上如何组织数据和元数据。
- 访问方法:如何把
open()、read()、write()转换为目录项、inode、位图和数据块访问。
简单 Unix 文件系统通常基于块数组结构;现代文件系统会使用哈希索引、B/B+ 树、日志等结构。
2. 文件系统块与磁盘布局
文件系统把存储空间划分为固定大小的块(Block),例如 4 KB,并从 0 到 N-1 编号。
典型布局包括:
- Superblock:超级块。
- inode bitmap:inode 位图。
- data bitmap:数据块位图。
- inode table:inode 表。
- data blocks:数据块区域。
超级块保存全局元数据:
- 文件系统类型。
- 块大小。
- inode 数量。
- 数据块数量。
- inode 表起始位置。
- 各区域布局信息。
挂载文件系统时,OS 会读取超级块。
3. 位图和空闲空间管理
Bitmap 是位图。文件系统通常使用两个位图:
- inode bitmap:记录 inode 是否已分配。
- data bitmap:记录数据块是否已分配。
一个 bit 表示一个对象状态:
- 1:已分配。
- 0:空闲。
位图优点:
- 容易找到连续空闲空间。
- 空间开销较低。
位图大小计算:
$$ \begin{gathered} n = \frac{D}{B} \ S_B = \frac{n}{8} \end{gathered} $$
符号说明:n 为块数量,也就是位图位数;D 为磁盘大小;B 为块大小;$S_B$ 为位图字节数。
例:1 TB 磁盘,4 KB 块:
$$ \text{blocks} = 2^{40} / 2^{12} = 2^{28} $$ $$ \text{bitmap_size} = 2^{28} bit\text{s} = 2^{25} byte\text{s} = 32 \text{MB} $$
空闲列表也可管理空闲块,但查找连续空间困难,分配多个块可能要遍历链表,并可能产生额外 I/O。
4. 块大小权衡
块太大:
- 顺序读写吞吐较好。
- 元数据开销小。
- 小文件内部碎片严重,浪费空间。
块太小:
- 空间利用率高。
- 大文件需要更多块和更多索引项。
- 随机读写多个块时 I/O 开销高。
文件系统块大小是空间利用率和 I/O 性能之间的权衡。
5. 文件组织方式
文件系统要维护从文件逻辑偏移到物理数据块的映射。
常见方式:
- 连续分配。
- 链表分配。
- FAT。
- 索引式分配。
- 多级索引。
6. 连续分配
Contiguous Allocation 是连续分配。每个文件占用一组连续数据块。
元数据只需记录:
$$ (b_0,n) $$
符号说明:b_0 为文件起始块号;n 为连续块数量。
优点:
- 顺序读写性能好。
- 快速定位任意数据块。
缺点:
- 创建时可能需要知道文件大小。
- 文件扩展困难。
- 外部碎片严重。
适合静态文件存储等场景。
7. 链表分配与 FAT
Linked Allocation 是链表分配。文件数据块组成链表,文件元数据记录第一个数据块。
优点:
- 没有外部碎片。
- 文件增长灵活。
缺点:
- 随机访问差,定位第 n 块需要遍历。
- 每个数据块要存指针,有空间开销。
- 指针损坏可能导致文件后续数据丢失。
FAT 是 File Allocation Table,全称文件分配表。
FAT 把链表的“下一块指针”集中放到一张表中。每个数据块对应 FAT 中一个表项,表项可表示:
- 下一个数据块编号。
- 文件结束标记。
- 空闲状态。
优点:
- FAT 可缓存在内存中,比在磁盘块中追指针更快。
- 实现简单,适合早期 Windows、DOS、USB、嵌入式设备。
缺点:
- 大磁盘上 FAT 本身可能很大。
例:1 TB 磁盘、4 KB 块、每表项 4 B:
$$ \begin{gathered} \text{entries} = 2^{40} / 2^{12} = 2^{28} \ \text{FAT_size} = 2^{28} \cdot 4B = 2^{30}B = 1\text{GB} \end{gathered} $$
8. 索引式分配
Indexed Allocation 是索引式分配。每个文件有一个索引块,索引块中保存该文件各逻辑块对应的物理块号。
优点:
- 随机访问好。
- 只需缓存当前打开文件的索引块,不需要缓存整个磁盘的表。
问题:
- 小文件可能浪费一个索引块。
- 大文件可能一个索引块不够,需要多个索引块或多级索引。
9. 多级索引
多级索引兼顾小文件和大文件。
inode 中维护固定数量指针:
- 直接指针:直接指向数据块。
- 一级间接指针:指向一个间接块,间接块中保存数据块指针。
- 二级间接指针:指向二级间接块。
- 三级间接指针:指向三级间接块。
小文件使用直接指针,访问路径短。大文件通过间接指针扩展容量。
容量计算例:块大小 4 KB,块指针 4 B。
一个间接块可保存:
$$ 4\text{KB} / 4B = 1024 \text{pointers} $$
若 inode 有 12 个直接指针:
- 直接指针容量:
12 * 4KB = 48KB。 - 一级间接容量:
1024 * 4KB = 4MB。 - 二级间接容量:
1024 * 1024 * 4KB = 4GB。 - 三级间接容量:
1024^3 * 4KB = 4TB。
10. 目录组织
目录本质上是特殊文件,内容由目录项组成。
Unix 类目录项通常保存:
$$ \langle\text{file name},\text{inode number}\rangle $$
FAT 目录项通常保存更多信息:
- 文件名。
- 属性。
- 时间。
- 起始 cluster。
- 文件大小。
现代目录项常采用变长结构,以支持不定长文件名。
目录查找:
- 小目录可线性扫描目录项。
- 大目录可用哈希索引、B+ 树等结构加速。
B+ Tree 是 B+ 树。现代文件系统常用文件名 hash 作为索引,在 B+ 树中定位目录项。
11. 文件操作的磁盘访问
mount():
- 读取超级块。
- 初始化内存中的文件系统结构。
open("/foo/bar"):
- 通常只做路径解析并打开文件。
- 访问目录 inode、目录数据块和目标 inode。
- 不读取
/foo/bar的文件内容数据块。
read(fd, buf, count):
- 根据 FD 找 open file description。
- 读取 offset。
- 找 inode。
- 根据文件块索引找到数据块。
- 读取数据并推进 offset。
write() 覆盖已有块:
- 找到目标数据块。
- 写数据。
- 更新 mtime/ctime 等元数据。
write() 追加并需要新块:
- 分配新数据块。
- 更新数据位图。
- 更新 inode 数据块索引和文件大小。
- 写入新数据块。
12. 文件系统性能:缓存与缓冲
文件系统性能关键在于减少慢速存储 I/O。一次 read() 或 write() 可能只访问内存缓存,不一定触发磁盘访问。
Caching 是缓存:
- FAT 可缓存 FAT 表的部分或全部。
- Unix/Linux 会缓存活跃 inode、目录项和文件数据页。
- 可利用时间局部性和空间局部性。
- 可通过预取提高顺序访问性能。
缓存指标:
$$ \begin{gathered} h = \frac{H}{N} \ m = \frac{M}{N} \ h + m = 1 \ L = hL_m + mL_d \ P = U / V \end{gathered} $$
符号说明:h 为缓存命中率;m 为缓存未命中率;H 为命中次数;M 为未命中次数;N 为请求总数;L 为平均 I/O 延迟;L_m 为内存缓存访问延迟;L_d 为磁盘访问延迟;P 为预取有效率;U 为真正被使用的预取块数;V 为预取块总数。
Buffering 是缓冲,尤其是写缓冲。
Write-through Policy 是直写策略:
- 修改后立即写回磁盘。
- 一致性较好。
- 可能导致大量随机写。
Write-back Policy 是写回策略:
- 修改后先标记为 dirty,延迟写回。
- 可合并小写,减少随机写。
- 性能更好。
- 崩溃时可能丢失尚未写回的数据。
写缓冲指标:
$$ \begin{gathered} \delta = \frac{D}{C} \ \beta = \frac{W}{T} \ \alpha = \frac{W_p}{W_l} \ L \le D_u \end{gathered} $$
符号说明:\delta 为脏块比例;D 为脏块数;C 为缓存块数;\beta 为写回速率;W 为写回块数;T 为时间;\alpha 为写放大;W_p 为物理写次数;W_l 为逻辑写次数;L 为崩溃时可能丢失的脏数据量;D_u 为尚未刷盘的脏数据量。
13. FFS
FFS 是 Fast File System,全称快速文件系统。Berkeley FFS 将磁盘划分为多个 cylinder groups,即柱面组。
每个 group 有自己的:
- 超级块副本。
- inode bitmap。
- data block bitmap。
- inode table。
- data blocks。
FFS 核心思想:利用局部性,把可能一起访问的数据放近。
分配策略:
- 创建文件时,同一文件的 inode 和 data 尽量放在同一个 group。
- 同一目录下的文件尽量放在同一个 group。
- 创建目录时,在目录较少、空闲 inode 较多的 group 中分配,均衡目录分布。
目的:
- 减少机械硬盘寻道。
- 提高顺序访问和相关文件访问性能。
14. 持久化中的一致性风险
写缓冲、设备缓存和多步元数据更新都会带来一致性风险。
例如追加写可能涉及:
- 分配数据块。
- 更新数据位图。
- 写数据块。
- 更新 inode 指针。
- 更新文件大小。
如果系统在中间崩溃,可能出现:
- 位图显示块已分配,但 inode 未引用。
- inode 指向未初始化数据块。
- 文件大小与实际块索引不一致。
课件后续若讲日志或崩溃一致性,应重点关注“多块更新如何原子化”。
三十二、持久化常考模板
1. 磁盘访问时间
$$ \begin{gathered} T_{IO} = S + R + X \ B = \frac{Q}{T_{IO}} \end{gathered} $$
平均旋转延迟:
$$ \begin{gathered} T_{rot}=\frac{60}{RPM} \ R_{avg}=\frac{T_{rot}}{2} \end{gathered} $$
符号说明:T_{IO} 为一次 I/O 时间;S 为寻道时间;R 为旋转延迟;X 为传输时间;B 为吞吐量;Q 为请求大小;T_{rot} 为旋转一圈时间;RPM 为每分钟转数;R_{avg} 为平均旋转延迟。
答题要点:
- 顺序访问主要看传输速率。
- 随机访问主要看寻道和旋转延迟。
- 小随机 I/O 吞吐远低于顺序 I/O。
2. 文件描述符共享关系
判断 offset 是否共享:
- 两次独立
open():不同 open file description,offset 不共享。 fork()继承 FD:共享同一个 open file description,offset 共享。dup()/dup2():共享同一个 open file description,offset 共享。
3. 路径解析访问次数
路径 /a/b/c 解析通常要逐级:
- 读取目录 inode。
- 读取目录数据块,查找名字。
- 得到下一级 inode number。
若缓存命中,可减少磁盘 I/O。题目一般会说明是否忽略缓存。
4. inode 定位计算
$$ \begin{gathered} o_i = i \cdot S_i \ A_i = A_0 + o_i \ b_i = \left\lfloor A_i / B \right\rfloor \ \delta_i = A_i \bmod B \end{gathered} $$
如果题目按扇区寻址:
$$ \begin{gathered} s_i = \left\lfloor A_i / S \right\rfloor \ \delta_i = A_i \bmod S \end{gathered} $$
符号说明:o_i 为 inode i 的偏移;i 为 inode 编号;S_i 为 inode 大小;A_i 为 inode 地址;A_0 为 inode 表起始地址;b_i 为块号;B 为块大小;\delta_i 为块内或扇区内偏移;s_i 为扇区号;S 为扇区大小。
注意 inode 编号从 0 还是从 1 开始。
5. 多级索引容量
给定:
B:块大小。P:指针大小。d:直接指针数量。
计算:
$$ \begin{gathered} n = \frac{B}{P} \ C_0 = dB \ C_1 = nB \ C_2 = n^2B \ C_3 = n^3B \end{gathered} $$
符号说明:n 为一个间接块可容纳的指针数;B 为块大小;P 为指针大小;C_0 为直接指针容量;d 为直接指针数量;C_1 为一级间接容量;C_2 为二级间接容量;C_3 为三级间接容量。
6. 位图大小
$$ \begin{gathered} n = \frac{D}{B} \ S_b = n \ S_B = \frac{n}{8} \end{gathered} $$
符号说明:n 为块数量;D 为磁盘大小;B 为块大小;S_b 为位图位数;S_B 为位图字节数。
inode 位图同理,只是对象数量换成 inode 数量。
7. 硬链接与符号链接
硬链接:
- 新目录项指向同一个 inode。
- link count 增加。
- 不能跨文件系统。
- 通常不能链接目录。
符号链接:
- 特殊文件,内容是目标路径。
- 可以跨文件系统。
- 可以指向目录。
- 可以指向不存在路径。
- 目标删除后会悬空。
三十三、持久化英文缩写速查
| 缩写 | 全称 | 中文 |
|---|---|---|
| DMI | Direct Media Interface | 直接媒体接口 |
| DMA | Direct Memory Access | 直接内存访问 |
| DRAM | Dynamic Random Access Memory | 动态随机访问存储器 |
| FAT | File Allocation Table | 文件分配表 |
| FD | File Descriptor | 文件描述符 |
| FFS | Fast File System | 快速文件系统 |
| GID | Group Identifier | 组 ID |
| HDD | Hard Disk Drive | 机械硬盘 |
| LBA | Logical Block Address | 逻辑块地址 |
| MMIO | Memory-Mapped I/O | 内存映射 I/O |
| NCQ | Native Command Queuing | 原生命令队列 |
| NVMe | Non-Volatile Memory Express | 非易失性内存主机控制器接口规范 |
| PCIe | Peripheral Component Interconnect Express | 高速串行计算机扩展总线标准 |
| PIO | Programmed I/O | 程序控制 I/O |
| RPM | Rotations Per Minute | 每分钟转数 |
| SATA | Serial Advanced Technology Attachment | 串行高级技术附件 |
| SSD | Solid State Drive | 固态硬盘 |
| SPTF | Shortest Positioning Time First | 最短定位时间优先 |
| SSTF | Shortest-Seek-Time-First | 最短寻道时间优先 |
| UID | User Identifier | 用户 ID |
| USB | Universal Serial Bus | 通用串行总线 |
| VFS | Virtual File System | 虚拟文件系统 |
三十四、持久化最后复习抓手
- I/O 设备通过状态、命令、数据寄存器与 OS 交互。
- 轮询简单但忙等浪费 CPU;中断允许计算与 I/O 重叠。
- PIO 由 CPU 搬运数据;DMA 由控制器直接在设备和内存之间搬运数据。
- HDD 随机访问慢,核心代价是寻道和旋转延迟。
- 磁盘调度要减少磁头移动和定位时间,但要注意饥饿。
- 文件是持久字节数组,inode 保存元数据和数据块索引,目录保存名字到 inode 的映射。
- FD 是进程私有句柄,offset 在 open file description 中。
fork()和dup()会共享 open file description,因此共享 offset。- 硬链接共享 inode;符号链接保存路径名。
- 文件系统布局通常包括超级块、位图、inode 表和数据块。
- 多级索引用直接指针照顾小文件,用间接指针扩展大文件。
- 缓存和写缓冲能提升性能,但会引入崩溃一致性风险。
三十五、全篇指标数学表达式汇总
1. CPU 调度指标
$$ \begin{gathered} X = \frac{N}{T} \ U = \frac{B}{T} \ T_i = C_i - A_i \ ATT = \frac{1}{n}\sum_i T_i \ R_i = F_i - A_i \ ART = \frac{1}{n}\sum_i R_i \ W_i = T_i - S_i \ NTT_i = \frac{T_i}{S_i} \ \varphi = \frac{\min_i Q_i}{\max_i Q_i} \ O_r = \frac{O}{q+O} \ E = \frac{q}{q+O} \end{gathered} $$
符号说明:X 吞吐量;N 完成任务数;T 总时间;U CPU 利用率;B CPU 忙碌时间;T_i 作业 i 的周转时间;C_i 完成时间;A_i 到达时间;ATT 平均周转时间;R_i 响应时间;F_i 首次运行时间;ART 平均响应时间;W_i 等待时间;S_i 实际运行时间;NTT_i 带权周转时间;\varphi 公平性比值;Q_i 进程 i 获得的资源份额;O_r RR 调度开销比例;O 每次调度开销;q 时间片长度;E 有效 CPU 时间比例。
2. 比例份额和 CFS 指标
$$ \begin{gathered} s_i = \frac{t_i}{\sum_j t_j} \ C_i \approx C_{total} \cdot s_i \ l_i = \frac{L}{t_i} \ p_i' = p_i + l_i \ k = \arg\min_i p_i \ \tau_i = \lambda\cdot\frac{w_i}{\sum_j w_j} \ v_i' = v_i+\Delta_i\cdot\frac{1024}{w_i} \ k = \arg\min_i v_i \end{gathered} $$
符号说明:s_i CPU 份额;t_i 彩票数;C_i 进程 i 获得的 CPU 时间;C_{total} 总 CPU 时间;l_i 步长;L 大常数;p_i pass 值;p_i' 更新后的 pass 值;k 被选中的进程;\tau_i CFS 时间片;\lambda 调度周期;w_i 权重;v_i 虚拟运行时间;v_i' 更新后的虚拟运行时间;\Delta_i 实际运行时间。
3. 内存和地址转换指标
$$ \begin{gathered} b = \log_2(P) \ v = a - b \ N_{PTE} = 2^v \ S_{PT} = N_{PTE} \cdot S_{PTE} \ VPN = VA \gg b \ d = VA \bmod P \ PA = PFN \cdot P + d \ h = \frac{H}{N} \ m = \frac{M}{N} \ EAT = hC_h + mC_m \end{gathered} $$
符号说明:b 页内偏移位数;P 页大小;v 虚拟页号位数;a 虚拟地址位数;N_{PTE} 页表项数量;S_{PT} 页表大小;S_{PTE} 单个页表项大小;VA 虚拟地址;VPN 虚拟页号;d 页内偏移;PA 物理地址;PFN 物理页帧号;h TLB 命中率;m TLB 未命中率;H 命中次数;M 未命中次数;N 地址转换总次数;EAT 有效地址转换代价;C_h 命中代价;C_m 未命中代价。
4. 页面置换指标
$$ \begin{gathered} h = \frac{K}{N} \ m = \frac{F}{N} \ h + m = 1 \ AMAT = H + mP \ AMAT = M + fD \ v_{OPT} = \arg\max_p next(p) \ v_{LRU} = \arg\min_p last(p) \ v_{LFU} = \arg\min_p count(p) \ B(k+1) > B(k) \end{gathered} $$
符号说明:h 命中率;m 未命中率;K 命中次数;F 缺页次数;N 内存访问次数;AMAT 平均内存访问时间;H 命中访问时间;P 未命中惩罚;M 内存访问时间;f 缺页率;D 缺页服务时间;v_{OPT} OPT 淘汰页;next(p) 页 p 下一次被访问时间;v_{LRU} LRU 淘汰页;last(p) 页 p 上次访问时间;v_{LFU} LFU 淘汰页;count(p) 页 p 访问次数;B(k) k 个页框时的缺页次数。
5. 空间管理指标
$$ \begin{gathered} I = A - R \ I_r = \frac{I}{A} \ E = \sum_i f_i \ M = \max(f_i) \ E \ge R \land M < R \ S_b = n \ S_B = \frac{n}{8} \end{gathered} $$
符号说明:I 内部碎片大小;I_r 内部碎片率;A 实际分配块大小;R 请求大小;E 空闲空间总量;f_i 第 i 个空闲块大小;M 最大空闲块大小;E ≥ R ∧ M < R 表示存在外部碎片;S_b 位图位数;S_B 位图字节数;n 被管理对象数量。
6. 并发指标
$$ \begin{gathered} L_i = a_i - r_i \ S_i = u_i - a_i \ \rho = \frac{C}{N} \ \omega = \frac{P}{T} \ X = \frac{K}{T} \ \varphi = \frac{\min_i G_i}{\max_i G_i} \ W_i \to \infty \ V = G + \sum_i L_i \ V_r = G \ \varepsilon = V - V_r = \sum_i L_i \ \varepsilon_r = \frac{\varepsilon}{V} \ N_{ij} = M_{ij} - C_{ij} \ \exists(p_1,...,p_n), \forall k: N_{p_k} \le W_k \ W_{k+1} = W_k + C_{p_k} \end{gathered} $$
符号说明:L_i 加锁等待时间;r_i 请求锁时间;a_i 获得锁时间;S_i 临界区时间;u_i 释放锁时间;\rho 锁竞争率;C 发生竞争的加锁次数;N 总加锁次数;\omega 自旋浪费比例;P 自旋消耗 CPU 时间;T 总 CPU 时间;X 锁吞吐量;K 完成临界区次数;\varphi 公平性比值;G_i 线程 i 成功获得锁次数;W_i -> ∞ 表示饥饿;V 近似计数器真实值;G 全局计数器;L_i 第 i 个局部计数器;V_r 读到的近似值;\varepsilon 绝对误差;\varepsilon_r 相对误差;N_{ij} 剩余资源需求;M_{ij} 最大需求;C_{ij} 已分配资源;p_k 安全序列中第 k 个线程;W_k 第 k 步可用资源向量。
7. 磁盘和文件系统指标
$$ \begin{gathered} T_{rot}=\frac{60}{RPM} \ R_{avg}=\frac{T_{rot}}{2} \ T_{IO} = S + R + X \ B = \frac{Q}{T_{IO}} \ d_i = |x_i - x_0| \ D = \sum_i d_i \ p_i = s_i + r_i \ k = \arg\min_i p_i \ o_i = i \cdot S_i \ A_i = A_0 + o_i \ b_i = \left\lfloor A_i / B_s \right\rfloor \ \delta_i = A_i \bmod B_s \ n_p = \frac{B_s}{S_p} \ C_1 = n_pB_s \ C_2 = n_p^2B_s \ C_3 = n_p^3B_s \ h = \frac{H}{N} \ L = hL_m + (1-h)L_d \ \delta = \frac{D_b}{C_b} \ \alpha = \frac{W_p}{W_l} \end{gathered} $$
符号说明:T_{rot} 磁盘旋转一圈时间;RPM 每分钟转数;R_{avg} 平均旋转延迟;T_{IO} 一次 I/O 时间;S 寻道时间;R 旋转延迟;X 传输时间;B 吞吐量;Q 请求大小或传输字节数;d_i 请求 i 的寻道距离;x_i 请求磁道号;x_0 当前磁头位置;D 总磁头移动距离;p_i 请求 i 的定位时间;s_i 寻道时间;r_i 旋转延迟;k SPTF 选择的请求;o_i inode i 的偏移;S_i inode 大小;A_i inode i 的地址;A_0 inode 表起始地址;b_i 所在块号;B_s 块大小;\delta_i 块内偏移;n_p 间接块可存放的指针数;S_p 指针大小;C_1 一级间接容量;C_2 二级间接容量;C_3 三级间接容量;h 缓存命中率;H 命中次数;N 请求总数;L 平均 I/O 延迟;L_m 内存访问延迟;L_d 磁盘访问延迟;\delta 脏块比例;D_b 脏块数;C_b 缓存块数;\alpha 写放大;W_p 物理写次数;W_l 逻辑写次数。